Viel gecrawlt, nicht empfohlen: Was KI-Crawler über deine Sichtbarkeit sagen
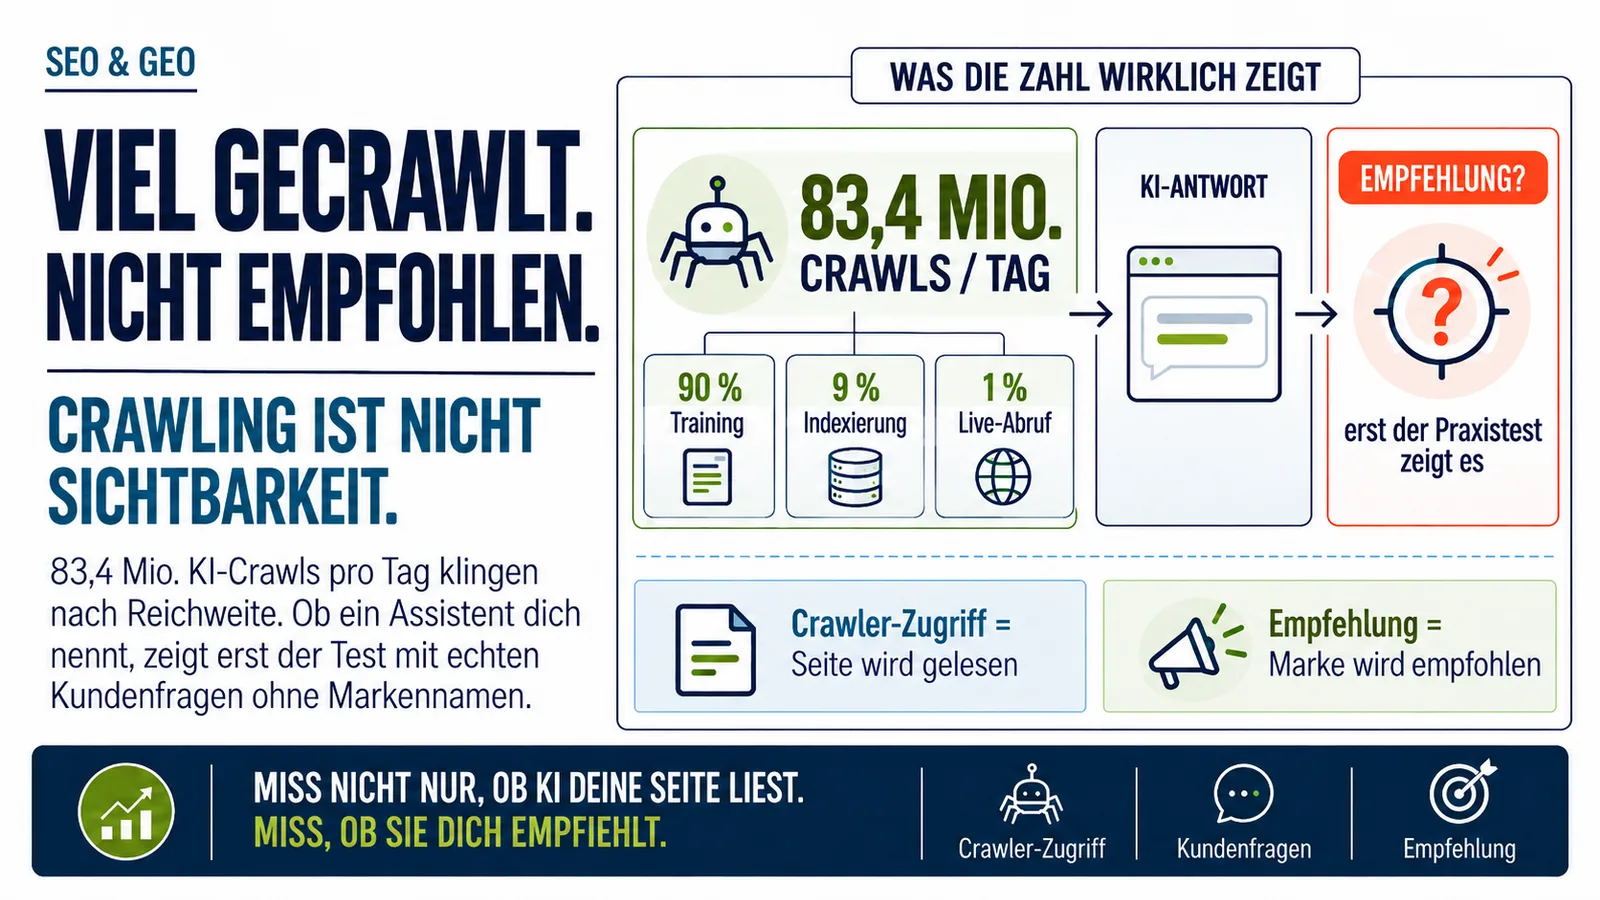
83,4 Millionen verifizierte Anfragen von KI-Crawlern zählt der Hoster Bluehost an jedem Tag auf den Websites seiner Kunden. Die Zahl stammt aus einer 90-tägigen Auswertung, die Sachin Puri im Podcast des Search Engine Journal genannt hat. Puri führt Newfold Digital, den Mutterkonzern von Bluehost. Crawler sind Programme, die Webseiten automatisch auslesen. Für die Optimierung auf Empfehlungen von KI-Assistenten, kurz GEO, klingt so eine Zahl nach Erfolg. Ein Selbsttest in ChatGPT zeigt, warum sie wenig darüber sagt.
Was die 83,4 Millionen messen
Bluehost hat die Anfragen nach ihrem Zweck sortiert. Rund 90 Prozent dienten demnach dem Training von Sprachmodellen, etwa 9 Prozent der Suchindexierung. Nur rund 1 Prozent waren Live-Abrufe. Gemeint ist der Moment, in dem ein Assistent eine Seite öffnet, weil ein Nutzer gerade eine Frage gestellt hat.
Zwei Einschränkungen gehören zu jeder Nennung der Zahl. Bluehost hat die Zwecke selbst eingeordnet, und gezählt wurden ausschließlich Websites, die bei Bluehost liegen. Käufe, Weiterleitungen oder Empfehlungen zeigen die Zahlen nicht. Puri beschreibt das Crawlen als ersten Schritt einer längeren Kette. Danach ruft ein System die Informationen ab, zitiert sie vielleicht in einer Antwort und empfiehlt im besten Fall das Unternehmen.
Ein Besuch auf 5.350 Crawls
Für ChatGPT nannte Puri eine Schätzung aus dem Bluehost-Bericht. Auf 5.350 verifizierte Crawls von HTML-Seiten kam ein Besuch, der sich als Weiterleitung aus ChatGPT erkennen ließ. Als Conversion-Rate will Puri das Verhältnis ausdrücklich nicht verstanden wissen. Im Crawl-Zähler steckt das Training mit drin, und Bluehost sieht längst nicht jede Kundenreise, die ein Assistent beeinflusst.
Puri rät deshalb, maschinelles Lesen und menschliche Besuche getrennt zu messen. Klicks zu messen und bestehende Anfragewege zu verbessern, bleibt trotzdem wichtig. Manche Kunden entscheiden sich allerdings nach dem, was ein Assistent ihnen gesagt hat, und diese Entscheidung taucht in keiner Webanalyse auf. Wie man mit dieser Lücke umgeht, beschreibe ich im Beitrag zur Attribution in KI-Antworten.
Meine Website lässt alle KI-Crawler rein
Die robots.txt ist die Datei, in der eine Website Crawlern sagt, was sie lesen dürfen. In der von tim-schoster.de steht für alle Crawler eine einzige Regel: Alles darf gelesen werden. Das habe ich bewusst so entschieden. OpenAI trennt laut eigener Doku zu seinen Crawlern drei Zugriffe. GPTBot sammelt Inhalte, die ins Training einfließen können. OAI-SearchBot sorgt dafür, dass eine Seite in den Suchergebnissen von ChatGPT erscheinen kann. ChatGPT-User ruft Seiten ab, wenn ein Nutzer das im Chat auslöst.
Für GPTBot und OAI-SearchBot lassen sich die Regeln unabhängig voneinander setzen. Bei ChatGPT-User greift die robots.txt laut OpenAI unter Umständen nicht, weil ein Mensch den Abruf auslöst. Wer nicht ins Training will, in der ChatGPT-Suche aber auftauchen möchte, sperrt GPTBot und lässt OAI-SearchBot zu. Bei mir dürfen beide lesen. Meine robots.txt erfüllt damit die Voraussetzung, die ChatGPT in einer meiner Testantworten nennt: OAI-SearchBot muss die Seite erreichen können.
Der Test ohne Markennamen
Am 13. Oktober habe ich ChatGPT drei Fragen gestellt, die mögliche Kunden von mir stellen könnten. Zum Beispiel: „Wer kann mir in Köln helfen, die Arbeit unserer Redaktion mit KI und n8n zu automatisieren?“ Die Chats liefen temporär, und mein Name stand in keiner Frage. In den Antworten fiel er ebenfalls nicht. ChatGPT nannte Agenturen aus Köln und Freelancer, deren Profile auf Plattformen wie Malt oder freelance.de stehen.
Die erste Frage habe ich zweimal gestellt. Beim ersten Durchgang nannte ChatGPT fünf Anbieter, beim zweiten vier. Nur zwei davon tauchten beide Male auf. Ein einzelner Test ist also eine Momentaufnahme. Puri empfiehlt, die Prüfung regelmäßig zu wiederholen. Das Ergebnis passt zu seinem Rat, Crawler-Volumen gar nicht erst als Ziel zu setzen. Offene Türen für Crawler führen nicht von selbst zu einer Empfehlung.
Puris Messraster für KI-Antworten
Puri schlägt ein Raster in drei Stufen vor. Am Anfang steht die Sichtbarkeit: Taucht das Unternehmen auf, wenn jemand eine passende Frage stellt, und wird es erwähnt oder zitiert? Danach geht es um die Richtigkeit von Preisen, Leistungen, Standorten und Öffnungszeiten. Zuletzt zählt die Wirkung, also eine messbare Weiterleitung, eine Anfrage, eine Buchung oder ein Kauf.
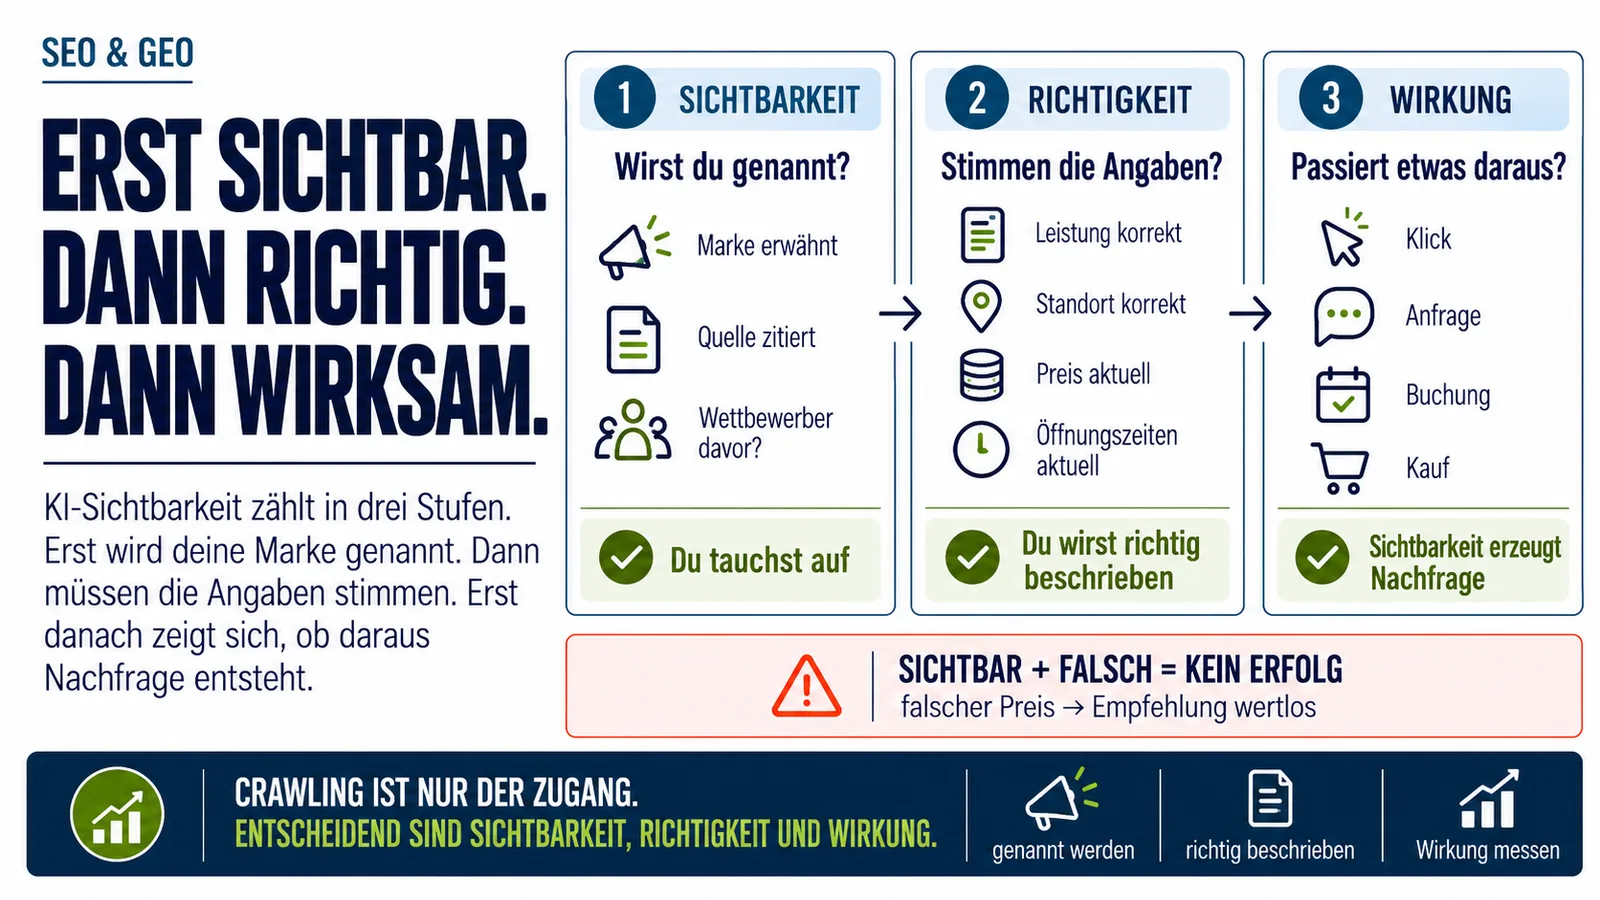
Jede Stufe hängt an der vorherigen. Eine Erwähnung mit falschem Preis hilft niemandem. Loren Baker, der Gründer des Search Engine Journal, führte das Gespräch und kennt veraltete Preise aus seiner Arbeit mit Kunden. Sie stehen noch auf der eigenen Website, im Schema-Markup oder in Diskussionen auf Plattformen wie Reddit. Schema-Markup sind strukturierte Daten im Quellcode, die Maschinen eine Seite erklären. KI-Systeme nutzen die Website laut Baker zunehmend, um Funde von anderswo gegenzuprüfen.
Fakten statt Keywords
In einem Gedankenspiel beschreibt Puri einen Kunden, der einen KI-Agenten losschickt. Ein Agent ist ein Assistent, der Aufgaben selbstständig erledigt. Gesucht ist ein Elektriker, der morgen Nachmittag Zeit hat, unter 300 Dollar bleibt und gute Bewertungen hat. Der Agent bucht den Termin gleich mit. Die Website des Elektrikers sieht der Kunde dabei womöglich nie.
Für seine Auswahl kann der Agent die Website samt Schema-Markup lesen. Dazu prüft er etwa das Google-Unternehmensprofil, Einträge bei Yelp und Bewertungen auf anderen Seiten. Von all diesen Quellen hat das Unternehmen allein die eigene Website vollständig in der Hand. Sie ist deshalb der Maßstab, an dem sich der Rest messen lassen muss. Wie du sie zur Quelle machst, der KI vertraut, beschreibe ich ausführlicher.
Viele lokale Leistungsseiten wurden laut Puri für Rankings gebaut. Sie enthalten viele Keywords und wenig Fakten. Ein Satz wie „zuverlässige Elektroarbeiten“ gibt einem Agenten kaum etwas an die Hand. Brauchbar wird die Seite mit Leistungen, Einsatzgebiet, Öffnungszeiten, Zulassung und aktuellen Bewertungen. Mehr Content repariert keine veralteten Angaben. KI verstärkt nach Puris Worten ein gutes Fundament genauso wie ein wackliges.
Womit du anfängst
Laut einer Bluehost-Studie unter kleinen Unternehmen gaben nur 13 Prozent der Befragten an, auf Sichtbarkeit in KI-Assistenten hinzuarbeiten. Wie viele Firmen befragt wurden, steht im Beitrag des Search Engine Journal nicht. Puris Einstieg kostet zehn Minuten am Tag. Stell ChatGPT, Gemini oder einem anderen Assistenten die Fragen, die deine Kunden vor einer Entscheidung stellen. Lass deinen Firmennamen weg, denn eine Abfrage mit Namen zeigt bloß einen engen Ausschnitt.
Halte danach fest, ob du erscheinst und ob der Assistent dich empfiehlt oder nur erwähnt. Notiere, welche Wettbewerber auftauchen und auf welche Quellen sich die Antwort stützt. Fehlende oder veraltete Angaben korrigierst du im nächsten Schritt. Fang mit der eigenen Website an, denn an ihr messen Agenten den Rest.