GEO-Tracking: Warum Google und API nur jede vierte ChatGPT-Quelle finden
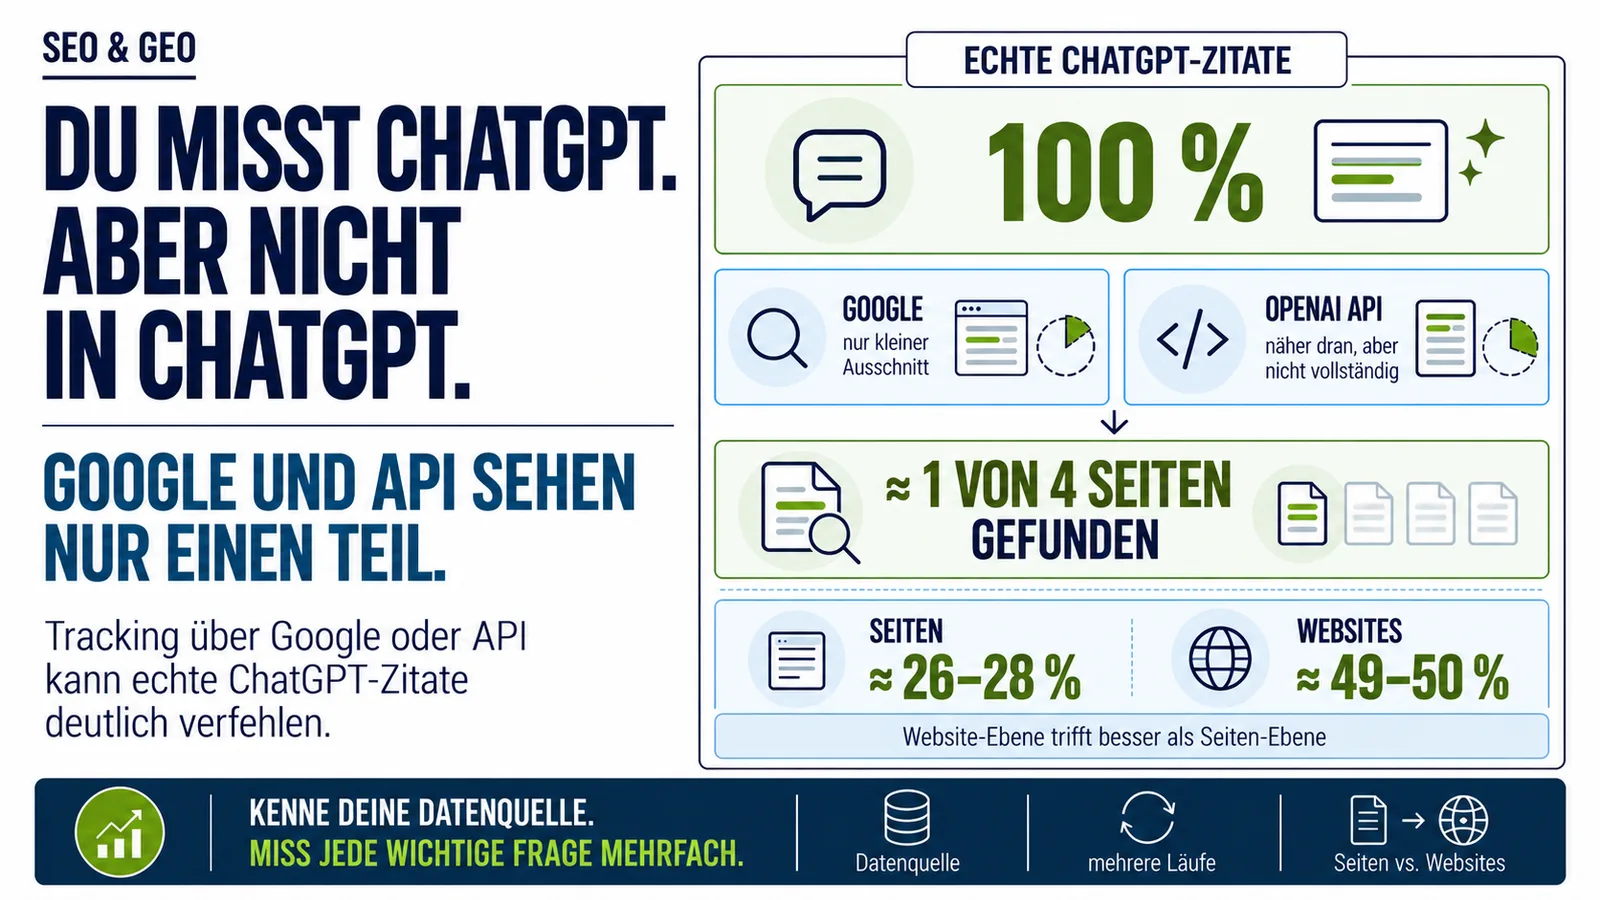
Wie oft nennt ChatGPT meine Website? Manche Tracking-Tools beantworten diese Frage, ohne die ChatGPT-Oberfläche zu befragen. Sie messen über Google-Ergebnisse oder über die Programmierschnittstelle von OpenAI, kurz API. Forschende der National University of Singapore und der Xi'an Jiaotong University haben in einem Preprint vom 11. Oktober geprüft, wie gut solche Ersatzquellen treffen. Zusammen fanden Google und API nur rund ein Viertel der Seiten, die ChatGPT als Quelle angab.
So lief die Untersuchung
Das Team zeichnete den Datenstrom auf, den die ChatGPT-Webanwendung in angemeldeten Sitzungen empfängt. Darin steht, welche Suchen ChatGPT absetzt, welche Seiten zurückkommen und welche davon das Modell am Ende zitiert. Die 80 Fragen stammen aus Search Arena, einer öffentlichen Sammlung echter Nutzerfragen an suchfähige Chatbots. Je 40 waren auf Englisch und auf Chinesisch. Jede Frage lief 20-mal auf GPT-5.3 Instant und auf GPT-5.5 Instant, größtenteils zwischen dem 29. März und dem 29. Juli 2026. Zwei weitere Einstellungen, GPT-5.2 Instant und GPT-5.4 Thinking, liefen seltener, weil OpenAI sie während der Erhebung abschaltete.
Zum Vergleich holte das Team pro Frage bis zu fünf Seiten organischer Google-Ergebnisse, im Schnitt rund 43 Treffer. Zusätzlich lief jede Frage 20-mal über die API von OpenAI mit eingeschalteter Websuche, jeweils innerhalb von drei Tagen nach dem ChatGPT-Lauf. Das Paper ist ein Preprint und damit noch nicht von Fachkollegen begutachtet. Am 18. Oktober berichtete das Search Engine Journal darüber.
Websites treffen besser als einzelne Seiten
Google und API zusammen fanden 26,2 Prozent der Seiten, die GPT-5.5 Instant zitierte, bei GPT-5.3 Instant waren es 28,3 Prozent. Auf Ebene der Websites stieg die Quote auf 48,7 und 50,3 Prozent. Als zitiert galt eine Seite, sobald ChatGPT sie in mindestens einem der 20 Läufe nannte. Subdomains wie blog.beispiel.de zählten dabei als eigene Websites.
Google allein lag deutlich darunter und fand nur 6,4 und 9,4 Prozent der zitierten Seiten. Ein gutes Ranking verrät also wenig darüber, welche Unterseite ChatGPT am Ende nennt. Die API lieferte breitere Treffer. Von den Seiten, die sie in ihren eigenen Antworten zitierte, nannte GPT-5.5 Instant im Schnitt 23,3 Prozent ebenfalls, GPT-5.3 Instant 16,4 Prozent. Näher an ChatGPT liegt die API damit als Google, deckungsgleich ist sie nicht.
Jeder Lauf sieht anders aus
Ein Grund für die Lücke liegt in den Suchanfragen. ChatGPT formuliert Fragen für die Websuche um. Bei GPT-5.3 Instant und GPT-5.5 Instant übernahm das Modell den Wortlaut der Originalfrage in keinem einzigen beobachteten Lauf, bei GPT-5.2 Instant in 5,5 Prozent. Zu chinesischen Fragen suchten GPT-5.3 Instant in 67,0 und GPT-5.5 Instant in 69,6 Prozent der Läufe ausschließlich auf Englisch. Ob deutsche Fragen ähnlich behandelt werden, hat die Studie nicht untersucht.
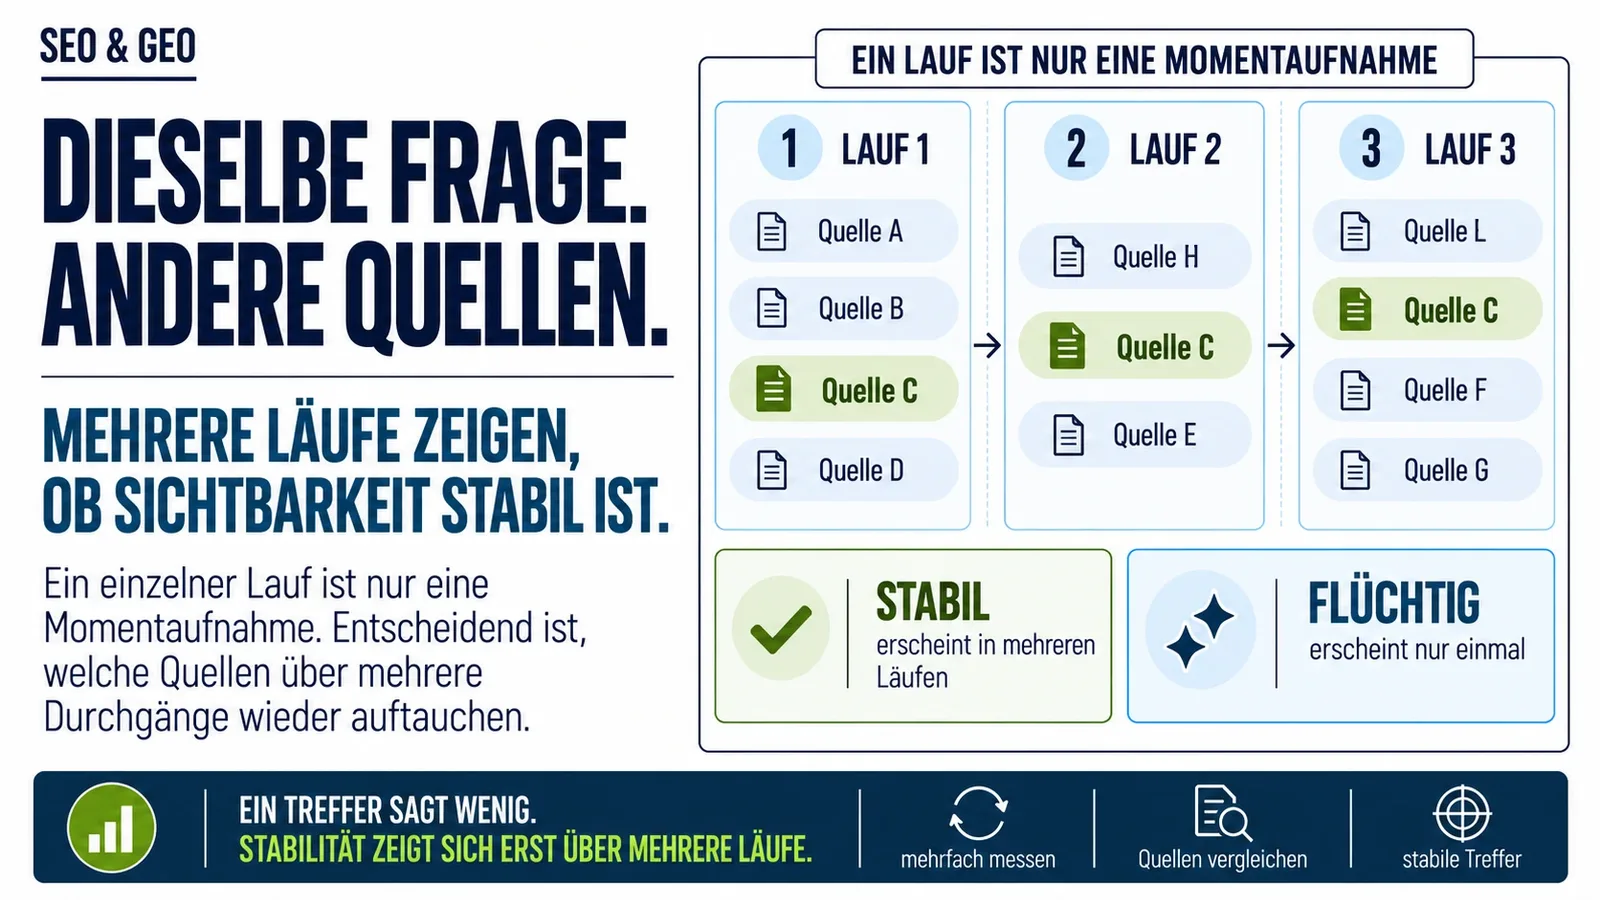
Dazu kommt Zufall zwischen den Durchgängen. Bei GPT-5.5 Instant tauchten 44,5 Prozent der abgerufenen Seiten zu einer Frage in nur einem von 20 Läufen auf, bei GPT-5.3 Instant 40,8 Prozent.
Zwei Messreihen wechselten nach 14 und 16 Läufen unbemerkt auf ein Ersatzmodell. Die Autoren raten deshalb, bei jeder Antwort zu prüfen, welches Modell sie erzeugt hat.
Mein eigener Test im Kleinen
Für meinen Beitrag über KI-Crawler und Sichtbarkeit habe ich am 13. Oktober dieselbe Frage zweimal in die ChatGPT-Oberfläche gestellt. Beim ersten Durchgang nannte ChatGPT fünf Anbieter, beim zweiten vier. Nur zwei davon tauchten beide Male auf. Zwei Durchgänge sind eine winzige Stichprobe. Das Muster entspricht trotzdem dem Befund der Studie. Wer eine Frage einmal stellt, sieht eine Momentaufnahme.
Was das für dein GEO-Monitoring heißt
Die Autoren empfehlen, Sichtbarkeit auf Ebene der Seiten und der Websites getrennt auszuwerten. Jede wichtige Frage sollte mehrfach laufen, weil sich Treffer zwischen den Durchgängen stark verschieben. Wer ein Tracking-Tool nutzt, fragt beim Anbieter nach, ob die Daten aus der API oder aus der ChatGPT-Oberfläche stammen. Kommerzielle Tools haben die Forschenden nicht getestet. Wie gut ein bestimmtes Produkt misst, bleibt offen.
Für Reports bietet sich die Quote auf Website-Ebene als Hauptkennzahl an, weil sie weniger schwankt. Der Wert pro Seite zeigt eher, welche Inhalte ChatGPT gerade greift. Dass Empfehlungen schon nach einer Rückfrage verschwinden können, habe ich in einem Beitrag zu KI-Empfehlungen im Gespräch beschrieben. Wie sich Besuche aus ChatGPT überhaupt zuordnen lassen, steht im Beitrag zur Attribution in KI-Antworten.
Modellwechsel verschieben die Basis
Alle getesteten Modelle stammen aus der Zeit vor GPT-5.6 und GPT-6. Wie stark ein Wechsel durchschlagen kann, zeigen Daten von Sistrix für deutschsprachige ChatGPT-Antworten. Rund um die Umstellung auf GPT-5.5 am 22. und 23. Mai sprang die Tagesschwankung der Zitate dort auf 47 Prozent, an normalen Tagen liegt sie bei 1 bis 2 Prozent. Sistrix verkauft selbst ein Tracking-Produkt und spricht von einer zeitlichen Korrelation. Werte über einen Modellwechsel hinweg lassen sich deshalb nur mit Vorsicht vergleichen.