Metas Crawling-Klausel: Was die neuen Geschäftsbedingungen auf deiner Website erlauben
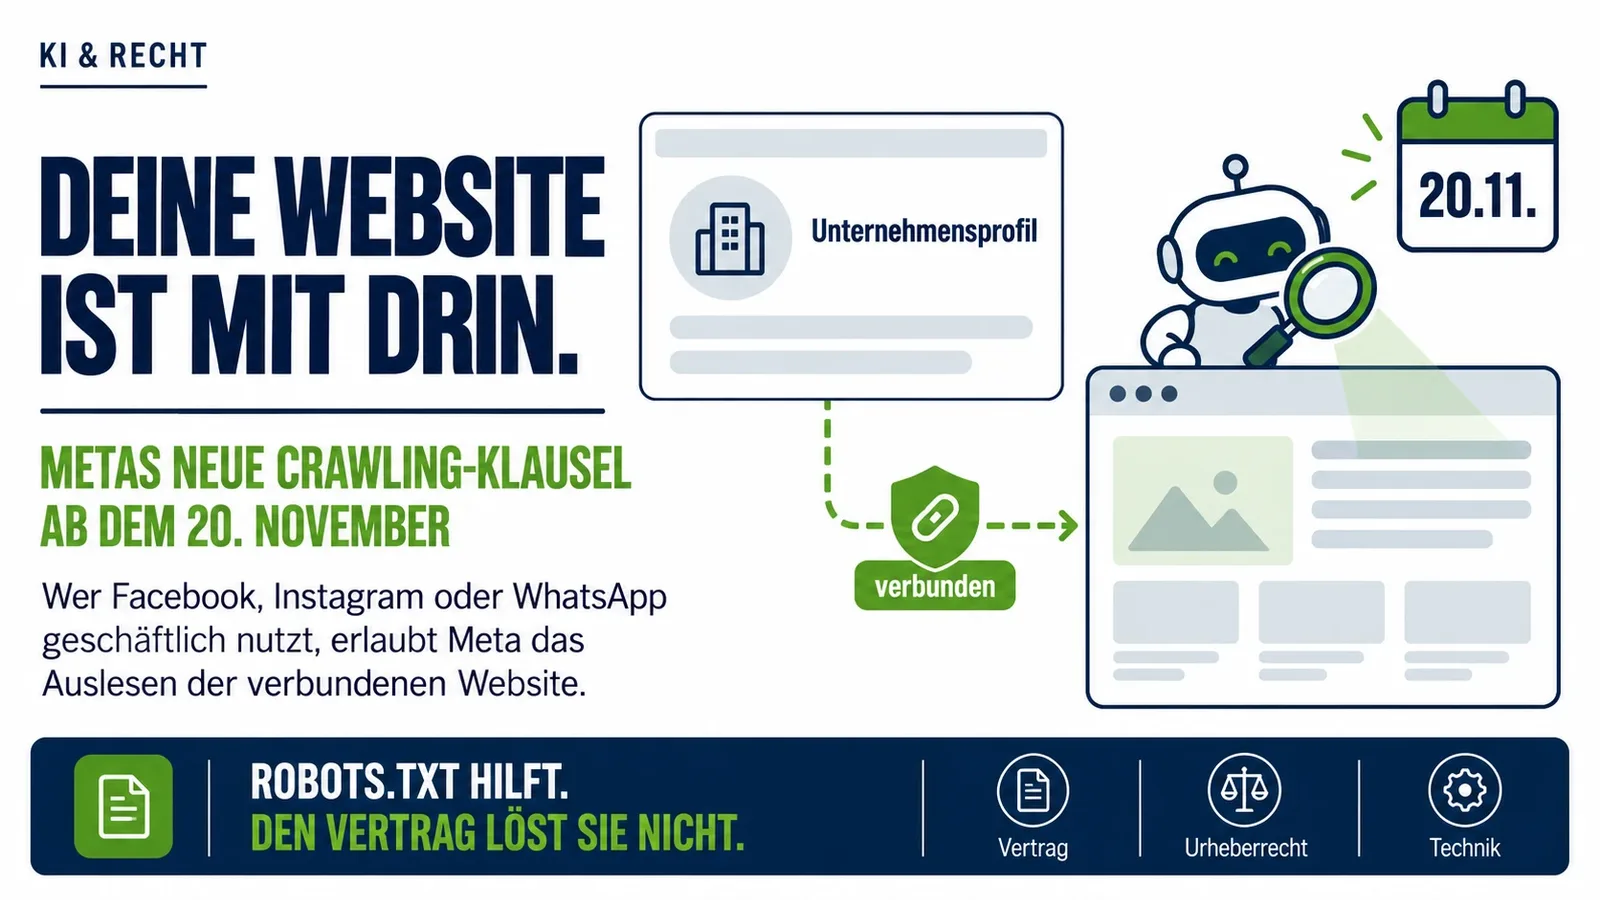
Meta wollte seine neuen Geschäftsbedingungen am 30. Oktober in Kraft setzen. Nach Beschwerden von Verlagen und Werbetreibenden bei der EU-Kommission und der britischen Wettbewerbsbehörde CMA hat der Konzern den Termin auf den 20. November verschoben, am Text aber nichts geändert. Darin steht eine Klausel, die jede Firma betrifft, die Facebook, Instagram oder WhatsApp geschäftlich nutzt. Meta darf Websites, die mit deinen Produkten oder Dienstleistungen verbunden sind, automatisch crawlen, zwischenspeichern und auswerten. Wer die Dienste nach dem Stichtag weiter nutzt, stimmt zu.
Was in der Klausel steht
Die Klausel erlaubt Meta, Crawler, Bots und andere automatische Software einzusetzen. Damit darf der Konzern Domains, Seiten und URLs abrufen, indexieren, zwischenspeichern und analysieren, die mit deinen Produkten oder Dienstleistungen verknüpft sind. Erfasst sind auch Seiten, die durch deine Nutzung von Metas Diensten oder die anderer Nutzer verfügbar gemacht werden. Dazu kommt das Recht, Testzugänge anzulegen und regelmäßig Aktualisierungen abzurufen. In der ersten Fassung stand als Zweck auch das Trainieren von Produkten. Nach Kritik hat Meta das Wort „train“ Mitte Oktober gestrichen. Jetzt dienen die Inhalte dazu, Werbe- und Business-Produkte bereitzustellen, zu entwickeln, zu verbessern, zu erforschen und zu pflegen, außerdem der Sicherheit von Metas eigenen Produkten.
Juristen halten die neue Fassung kaum für enger. Der US-Anwalt Matt Topic hält „develop“ für weit genug, um Training einzuschließen. „Business product“ scheine zudem nirgends definiert zu sein. James Grimmelmann, Rechtsprofessor an der Cornell University, nannte die Zweckangabe so breit, dass man einen Lastwagen hindurchfahren könne. Was „verknüpft“ genau heißt und welche Seiten andere Nutzer „verfügbar machen“, legt Meta ebenfalls nicht fest. Ob schon ein Meta-Pixel oder eine verifizierte Domain reicht, ist offen.
Werbekunden betrifft das schon heute
Für Werbekunden ist eine Crawling-Erlaubnis nicht neu. Die bisherigen Commercial Terms vom März 2024 enthalten keine Crawling-Klausel. Wer Anzeigen schaltet, hat aber den Self-Serve Ad Terms vom August 2025 zugestimmt. Dort darf Meta die Domains von Werbekunden schon jetzt crawlen, ausdrücklich auch für Forschung und Training. Neu ist, dass die Erlaubnis künftig für alle gilt, die Meta geschäftlich nutzen: wer eine Facebook-Seite pflegt, ein Instagram-Business-Profil führt, Produkte in einem Katalog listet oder WhatsApp Business einsetzt. Private Profile bleiben außen vor.
Wer sich wehrt
In Deutschland haben die Verlegerverbände BDZV und MVFP am 20. Oktober die EU-Kommission aufgefordert, die Klausel zu prüfen und bis zum Abschluss zu untersagen. Sie sehen einen Verstoß gegen den Digital Markets Act, der faire Zugangsbedingungen verlangt. Auch ohne das Wort „Training“ deckt die Klausel aus ihrer Sicht KI-Zusammenfassungen und Antworten auf Basis fremder Inhalte. Die britische Initiative Movement for an Open Web hat Beschwerde bei der Kommission und der CMA eingereicht und vorläufige Maßnahmen beantragt. Brüssel begrüßt die Verschiebung und will die Beschwerde prüfen. Angeordnet hat bisher keine Behörde etwas.
Fünf Crawler, fünf Zwecke
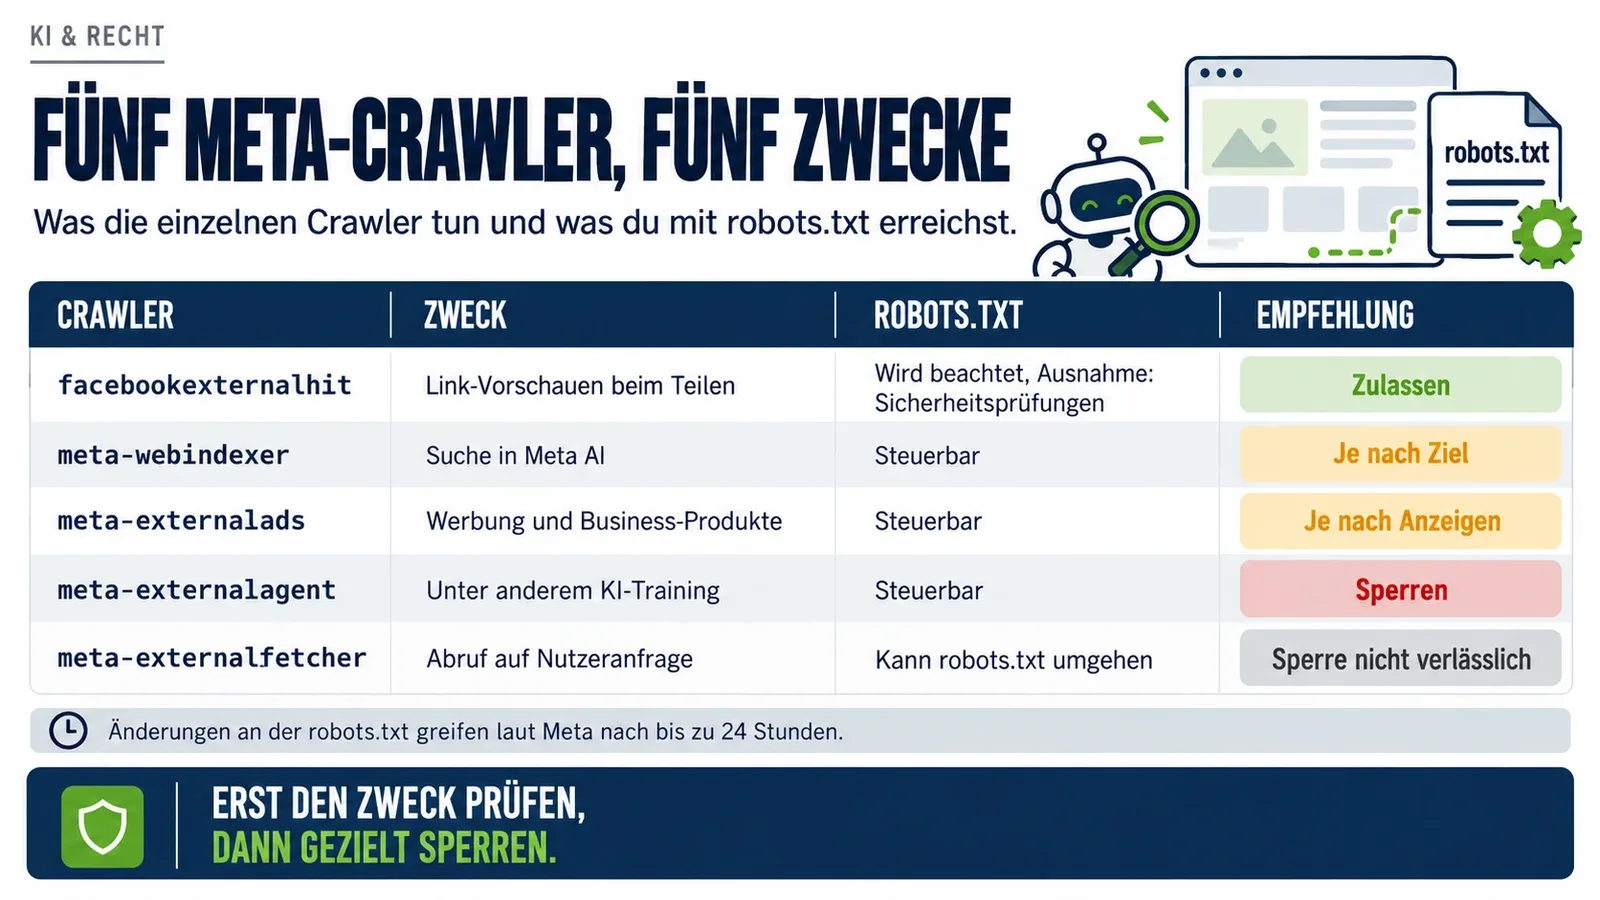
Meta selbst trennt die Zwecke genauer als der Vertrag. Auf seiner Seite für Webmaster nennt der Konzern fünf Crawler. Wenn jemand einen Link teilt, holt facebookexternalhit Titel, Beschreibung und Vorschaubild. Inhalte für die Suche in Meta AI sammelt der meta-webindexer. Wer ihn zulässt, kann dort zitiert werden. Für Werbung und andere Business-Produkte crawlt meta-externalads und passt vom Zweck her am besten zur neuen Klausel. Das Training von KI-Modellen nennt Meta als einen Zweck des meta-externalagent. Einzelne Seiten ruft schließlich der meta-externalfetcher ab, wenn ein Nutzer das verlangt, etwa über die KI-Funktionen von Meta.
Zwei davon halten sich nicht in jedem Fall an robots.txt. Den Fetcher lässt Meta die Datei umgehen, weil ein Mensch den Abruf ausgelöst hat. Der Link-Crawler kann sie bei Sicherheitsprüfungen umgehen. Änderungen an der robots.txt greifen nach bis zu 24 Stunden, so lange halten Metas Crawler die Datei vor.
Was du mit robots.txt erreichst
Der klarste Schritt ist, meta-externalagent zu sperren, denn diesen Crawler nennt Meta ausdrücklich für das Training von KI-Modellen. Pro Crawler braucht es zwei Zeilen, etwa „User-agent: meta-externalagent“ und darunter „Disallow: /“. Bei meta-externalads kommt es darauf an, ob du Anzeigen bei Meta schaltest. Welche Werbefunktionen ohne diesen Crawler schlechter laufen, dokumentiert Meta nicht. Ob du den meta-webindexer sperrst, hängt davon ab, ob du in KI-Antworten auftauchen willst. Den facebookexternalhit lässt du am besten zu, sonst fehlen geteilten Links die Vorschaubilder.
Das Volumen ist beträchtlich. Im dritten Quartal hat DataDome, ein Anbieter von Bot-Schutz, in seinem Kundennetz knapp 25 Milliarden Anfragen von KI-Agenten gemessen. Fast die Hälfte davon, 12,4 Milliarden, stammte von meta-externalagent und meta-webindexer. Verweise aus Meta AI zurück auf die Websites zählte DataDome im selben Zeitraum nur rund 51.000. Anfang 2026 war meta-externalagent in diesem Netz zudem der am häufigsten gefälschte Name eines KI-Agenten. Ein Eintrag in robots.txt wirkt also nur bei Crawlern, die sich an die Regeln halten. Was viele Crawls über die eigene Sichtbarkeit sagen, steht im Beitrag über KI-Crawler und GEO.
Vertrag, Urheberrecht, Technik
Die Vertragsfrage beantwortet robots.txt nicht. Meta sagt, Website-Betreiber könnten ihre Wünsche weiter über robots.txt signalisieren, die neuen Bedingungen gäben dem Konzern keine Rechte, die das aushebeln. Im Vertragstext steht davon nichts. Der Rechtsprofessor Benjamin Sobel von der University of Wisconsin weist darauf hin, dass die Beachtung von robots.txt freiwillig ist und Websites daraus kein durchsetzbares Recht ableiten können. Der europäische Verlegerverband EPC sieht es ähnlich: Technische Kontrollen könnten klare vertragliche Grenzen nicht ersetzen.
In Deutschland kommt das Urheberrecht dazu. Nach § 44b UrhG darf man rechtmäßig zugängliche Werke für Text und Data Mining kopieren, solange der Rechteinhaber das nicht vorbehalten hat. Bei Online-Inhalten wirkt der Vorbehalt nur, wenn er maschinenlesbar ist. Robots.txt ist ein solches Signal, und der Verhaltenskodex der EU für Anbieter großer KI-Modelle verpflichtet die Unterzeichner ausdrücklich, die Datei zu beachten. Meta hat den Kodex im Juli 2025 allerdings nicht unterschrieben. Ob ein Vorbehalt auch gegen eine Erlaubnis hilft, die du Meta per Vertrag erteilst, hat noch kein Gericht entschieden.
Haftung für fremde Inhalte
Ein Punkt geht in der Debatte unter. Die US-Kanzlei Shumaker erinnert daran, dass Unternehmen Meta nur Rechte an Inhalten einräumen können, die ihnen selbst zustehen. Stockfotos, Agenturtexte oder Gastbeiträge auf der eigenen Website gehören oft nicht dazu. Über die Freistellungspflichten in den Bedingungen kann das zum Problem des Unternehmens werden. Ob diese Regeln nach deutschem Recht in vollem Umfang halten, ist nicht geklärt.
Was belegt ist und was offen bleibt
Belegt sind der Wortlaut der Vorschau, die Verschiebung auf den 20. November und Metas eigene Beschreibung der Crawler. Die deutsche Vorschau nennt inzwischen ebenfalls den 20. November. Am 25. Oktober zeigte sie laut Search Engine Journal noch das alte Datum. Offen ist, was „verknüpft“ genau umfasst und wofür Meta Testzugänge anlegen will. Ebenso unklar ist, ob Kommission oder CMA bis zum Stichtag eingreifen. Für Streitigkeiten mit Meta Platforms Ireland nennt die aktuelle deutsche Fassung ausschließlich irische Gerichte. Dieser Beitrag ersetzt keine Rechtsberatung.
Was du bis zum 20. November prüfen kannst
Sechs Fragen helfen, die eigene Lage einzuschätzen, bevor die neuen Bedingungen greifen.
- 1Welche Meta-Dienste nutzen wir geschäftlich?Facebook-Seiten, Instagram-Business-Profile, Anzeigen, Produktkataloge und WhatsApp Business. Konten, die eine Agentur für dich betreut, zählen mit.
- 2Welche URLs kennt Meta von uns?Links in Profilen, Zielseiten von Anzeigen, Produkt-URLs im Katalog und Websites, die ein Meta Business Agent als Wissensquelle nutzt. Solche Seiten liest der Agent laut Meta regelmäßig neu ein.
- 3Was steht in unserer robots.txt?Lege fest, welche der fünf Meta-Crawler du zulässt. Für Link-Vorschauen brauchst du facebookexternalhit, für Zitate in Meta AI den meta-webindexer.
- 4Haben wir einen maschinenlesbaren Nutzungsvorbehalt?Für § 44b UrhG zählt nur ein Vorbehalt, den Maschinen lesen können. Robots.txt ist ein solches Format.
- 5Welche Inhalte gehören uns nicht?Stockfotos, Agenturtexte, Gastbeiträge und Kundenmaterial. Prüfe, ob deine Lizenzen eine Weitergabe an Meta abdecken.
- 6Welche Fassung haben wir angenommen?Speichere die Vorschau mit Datum als PDF. Die Länderfassungen waren zeitweise nicht auf demselben Stand.
Fang mit der robots.txt an. Sperr meta-externalagent und lass facebookexternalhit zu. Bei meta-externalads und meta-webindexer hängt die Entscheidung davon ab, ob du bei Meta Anzeigen schaltest und in KI-Antworten auftauchen willst. Prüf danach in deinen Server-Logs, ob die Meta-Crawler sich daran halten. Bis zum 20. November kann sich noch etwas bewegen: Kommission und CMA prüfen die Beschwerden, und den Text hat Meta schon einmal geändert.
Quellen
- Search Engine Journal: Meta Delays The Terms That Let It Crawl Business Sites
- Search Engine Journal: Meta’s New Terms Expand Crawling Rights Beyond Advertisers
- Search Engine Journal: Meta Drops Training From Its Crawl Clause And Keeps The Crawl
- Meta: Commercial Terms (Vorschau)
- Meta for Developers: Meta Web Crawlers
- Meta for Developers: Business Agent, Websites als Wissensquelle
- BDZV: Meta greift nach der gesamten digitalen Presse
- European Publishers Council: Meta needs to draw a clear line
- Movement for an Open Web: Competition Complaint Over Meta Business Terms
- § 44b UrhG: Text und Data Mining
- EU-Kommission: AI and copyright compliance
- TechCrunch: Meta refuses to sign EU’s AI code of practice
- DataDome: The AI Traffic Report Q3 2026
- DataDome: Businesses struggle to identify AI agent traffic
- Shumaker: Meta’s New Commercial Terms
Alle Quellen zuletzt geprüft am 29. Oktober 2026.