Gemeinsamer KI-Opt-out in robots.txt: Was die neue Zeile bewirkt und wer bis März 2027 handeln muss
Am 30. Oktober haben Google, Microsoft und OpenAI angekündigt, eine gemeinsame Zeile in der robots.txt zu beachten. Mit ihr sagt eine Website allen beteiligten Anbietern auf einmal, dass ihre Inhalte nicht ins Training von KI-Modellen fließen sollen. Den Vorschlag hat ein Mitarbeiter von Anthropic bei der IETF eingereicht, dem Gremium, das Internetstandards erarbeitet. Unterstützt wird die Zeile heute von keinem Anbieter. Dazu legt jeder der drei sie anders aus.
Die neue Zeile
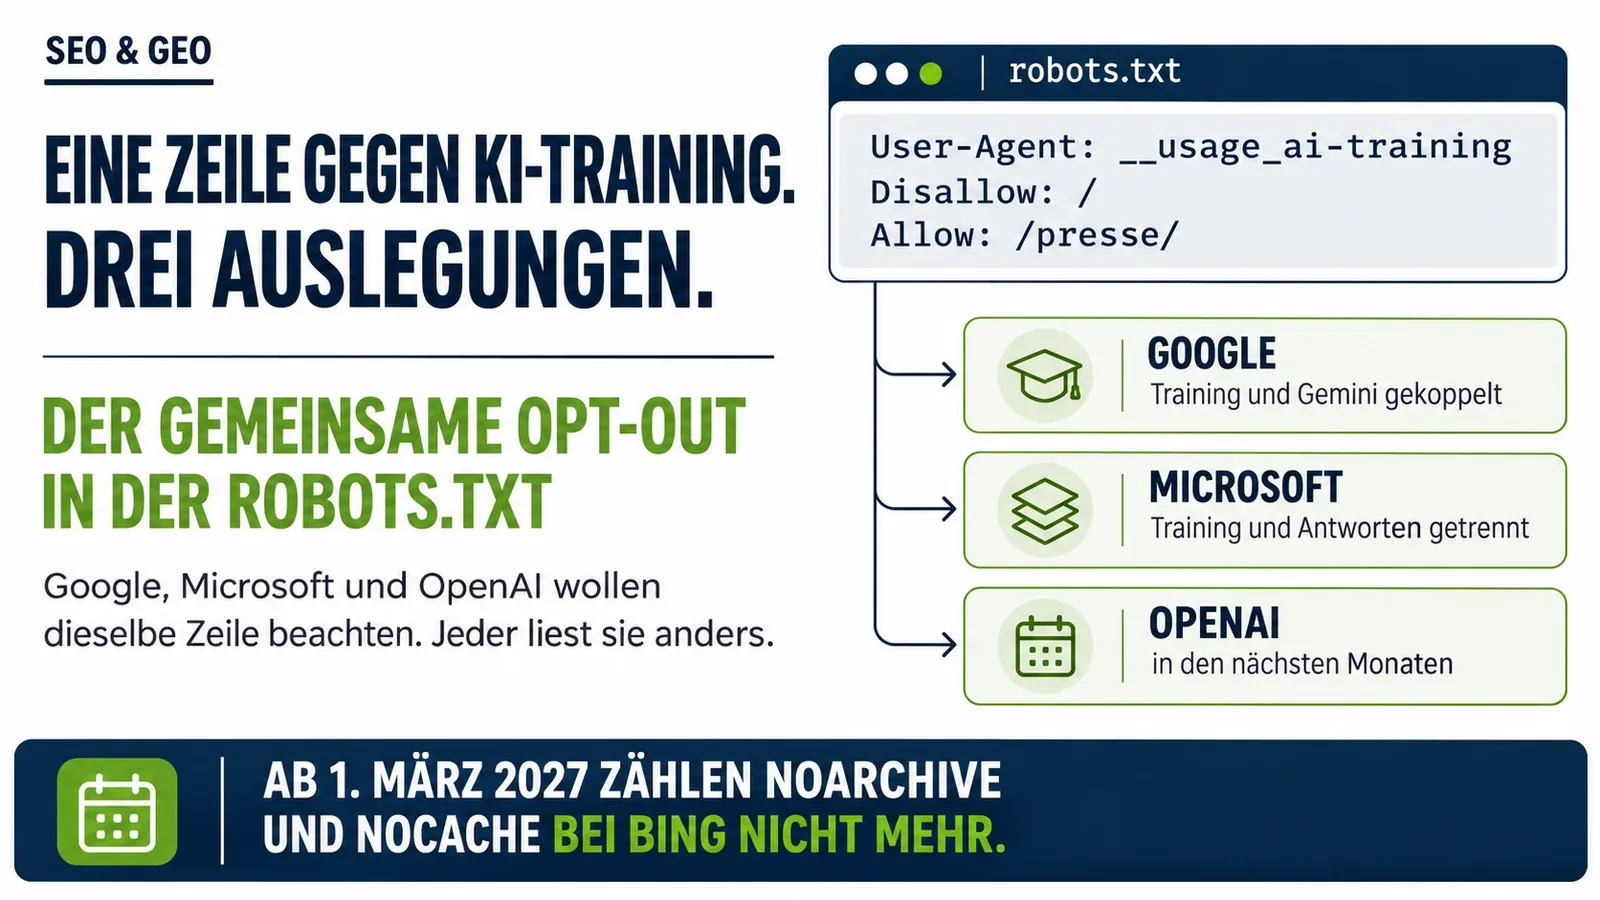
Der Entwurf heißt „Machine-Readable Training Preference Signal“ und stammt von Kevin Kelley, der bei Anthropic arbeitet. Neue Befehle braucht er nicht. Er reserviert einen festen Namen, der dort steht, wo sonst ein Crawler genannt wird: __usage_ai-training. Wer kein Training will, schreibt „User-Agent: __usage_ai-training“ und darunter „Disallow: /“. Mit „Allow“ lassen sich einzelne Pfade wieder freigeben, etwa der Pressebereich. Gemeint ist laut Entwurf nur das Training generativer Modelle, also jede Nutzung, die die gelernten Parameter eines Modells verändert.
Für die Wirkung zählen ein paar Details. Die Gruppe „User-Agent: *“, die für alle Crawler gilt, zählt für das Signal ausdrücklich nicht. Fehlt die neue Gruppe, hat die Website keine Präferenz geäußert. Das trifft laut Kelley auf jede robots.txt zu, die heute im Netz steht, auch auf Dateien, die GPTBot oder ClaudeBot längst sperren. Bei OpenAI und Anthropic wirken solche Sperren weiter, für das gemeinsame Signal zählen sie nicht. Crawling regelt die Zeile ebenfalls nicht. Ein Anbieter darf eine Seite weiter abrufen, er soll sie nur nicht fürs Training verwenden.
Noch ist das Ganze ein Vorschlag. Der Text ist ein sogenannter Individual Draft in der Version 00. Die IETF hat ihn nicht beschlossen, und er läuft am 3. Mai 2027 aus, wenn ihn niemand erneuert. Kelley will die Idee in einen Entwurf der Arbeitsgruppe AI Preferences einbringen, die an einem gemeinsamen Vokabular für solche Nutzungswünsche arbeitet. Wann daraus ein Standard wird, ist offen. Anthropic hat nach Kelleys Angaben begonnen, die Unterstützung zu bauen, und will sie neben den bestehenden Crawler-Regeln anbieten.
Google koppelt Training und Gemini
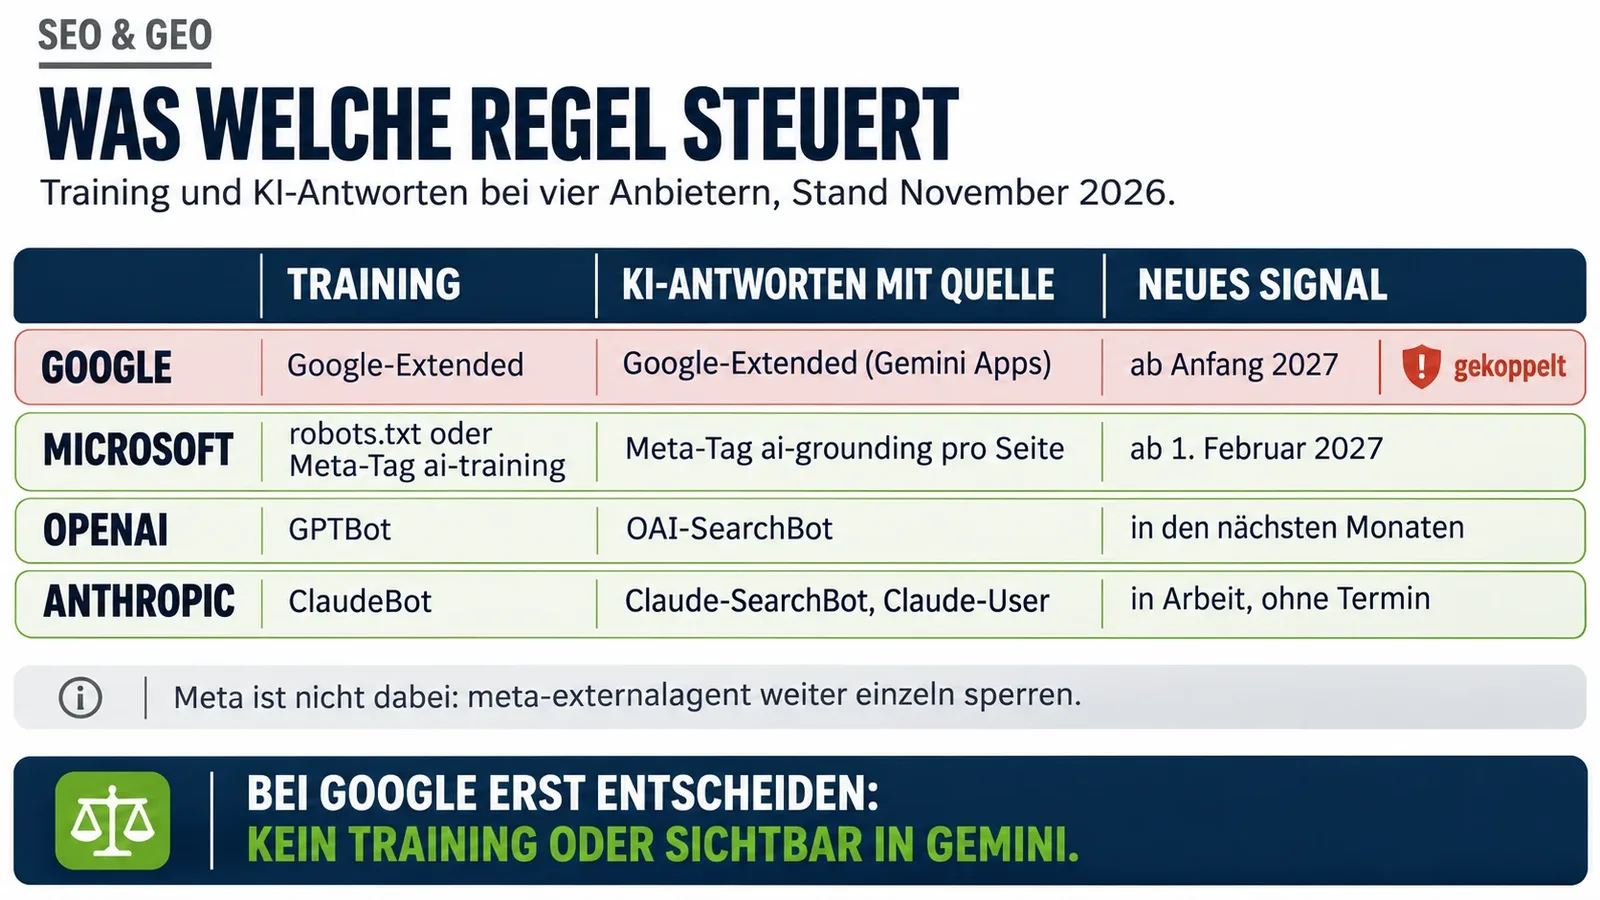
Google will die Zeile 2027 unterstützen, die Crawler-Dokumentation nennt Anfang 2027. Wie Google sie liest, beschreibt John Mueller im Search-Central-Blog. Steht in der robots.txt ein Disallow für das neue Signal und keine eigene Regel für Google-Extended, behandelt Google das wie ein Disallow für Google-Extended. Dieser Name steuert zwei Dinge zugleich: das Training künftiger Gemini-Modelle und das Grounding in den Gemini Apps und in Vertex AI. Grounding heißt, dass ein Modell beim Antworten aktuelle Inhalte heranzieht und als Quelle verlinkt.
Wer bei Google das Training sperrt, verschwindet damit auch aus den Antworten der Gemini Apps. Getrennt einstellen lässt sich das laut Googles Dokumentation nicht. Setzt du ausdrücklich eine Regel für Google-Extended mit „Allow: /“, gilt nach Muellers Beschreibung diese Regel, und sie erlaubt auch das Training. Auf die Google-Suche wirkt Google-Extended laut Google nicht. Ob deine Inhalte in AI Overviews, im AI Mode und in Discover auftauchen, steuerst du über eine eigene Einstellung in der Search Console, die seit dem 31. August für alle Websites verfügbar ist. Was ein Ausstieg dort kostet, steht im Beitrag über AI Overviews und deinen Traffic.
Microsoft trennt Training und Antworten
Bei Microsoft laufen die beiden Zwecke über getrennte Angaben. Fürs Training liest Bing das neue Signal in der robots.txt. Einzelne Seiten lassen sich zusätzlich mit dem Meta-Tag „Bingbot“ und dem Wert „ai-training:disallow“ oder per HTTP-Header sperren, und diese Angabe hat Vorrang vor der robots.txt. Grounding stellst du nur pro Seite ein, die robots.txt kennt dafür keinen Eintrag. Drei Werte sind möglich: allow, disallow und disallowextended. Mit dem letzten erlaubst du Antworten in Microsofts eigenen Produkten wie Copilot und Microsoft 365. Ausgeschlossen sind dann Dienste, über die andere Firmen Bing-Inhalte für ihre KI abrufen, etwa Web IQ.
Auf die normale Bing-Suche wirken beide Einstellungen laut Microsoft nicht. Indexieren und Ranken zählt dort ausdrücklich nicht als Grounding. Ohne Angabe gilt für Training und Grounding die Voreinstellung, und die erlaubt beides.
Wer bis März 2027 handeln muss
Eine echte Frist gibt es nur bei Microsoft. Sie betrifft Websites, die Copilot heute mit den Meta-Tags NoArchive oder NoCache fernhalten. Gedacht waren diese Tags gegen zwischengespeicherte Kopien, Microsoft hat sie bisher auch für Training und Grounding ausgewertet. Ab dem 1. Februar 2027 beachtet Bing beim Crawlen die neuen Angaben. Ab dem 1. März 2027 zählen NoArchive und NoCache für Training und Grounding nicht mehr. Wer bis dahin nichts ändert, fällt auf die Voreinstellung zurück. Microsoft warnt ausdrücklich davor, anzunehmen, die alten Sperren würden automatisch übernommen.
Ab dem 15. Dezember öffnet Microsoft in den Bing Webmaster Tools eine Übergangseinstellung. Sie gilt nur fürs Grounding und nur für Websites, die an diesem Tag noch NoArchive oder NoCache nutzen. Spätestens am 30. September 2027 läuft sie aus, früher, sobald Bing auf der Seite die neue Angabe findet. Eine Übergangslösung fürs Training gibt es nicht, das setzt du in der robots.txt oder per Tag. Jede Änderung wirkt zudem erst, wenn Bing die Seite neu abruft. Auch IndexNow garantiert laut Microsoft keinen Termin dafür.
OpenAI, Anthropic und wer fehlt
OpenAI will das Signal in den nächsten Monaten beachten, bis dahin gelten die bisherigen Regeln. Dort sind Training und Antworten schon heute getrennt. Laut der Doku zu den OpenAI-Crawlern sammelt GPTBot fürs Training und OAI-SearchBot für die Suche in ChatGPT, beide lassen sich unabhängig voneinander sperren. Bei Anthropic heißen die Gegenstücke ClaudeBot für das Training sowie Claude-SearchBot und Claude-User für Suche und Abrufe auf Anfrage. Was gilt, wenn das neue Signal und eine Regel für GPTBot sich widersprechen, hat OpenAI nicht beschrieben. Der Entwurf erlaubt Anbietern, Regeln für ihre eigenen Crawler als spezieller zu werten.
Meta ist nicht dabei. Wer Meta vom Training ausschließen will, braucht weiter eine eigene Regel für meta-externalagent, wie der Beitrag über Metas Crawling-Klausel zeigt. Dasselbe gilt für Apple mit Applebot-Extended und für jeden anderen Anbieter, der sich nicht angeschlossen hat.
Was das rechtlich bedeutet
In Deutschland erlaubt § 44b UrhG Text und Data Mining mit frei zugänglichen Inhalten, solange der Rechteinhaber das nicht maschinenlesbar vorbehalten hat. Robots.txt ist ein solches Format. Der im Juli 2025 veröffentlichte Verhaltenskodex der EU für Anbieter großer KI-Modelle verpflichtet die Unterzeichner, die Datei zu beachten, andere maschinenlesbare Protokolle sollen sie nach besten Kräften berücksichtigen. Ob ein Gericht die neue Zeile als Vorbehalt anerkennt, ist nicht entschieden. Einen Vorteil hat sie schon jetzt: Sie nennt ausdrücklich die Nutzung, um die es geht. Eine Sperre für GPTBot drückt das nur über den Namen des Crawlers aus. Dieser Beitrag ersetzt keine Rechtsberatung.
Meine eigene robots.txt
Auf tim-schoster.de steht für alle Crawler eine einzige Regel: Alles darf gelesen werden. Nach dem Entwurf drückt die Datei damit keine Präferenz aus, weder dafür noch dagegen. Ich will in KI-Antworten auftauchen, und bei Google würde ein Training-Opt-out die Gemini Apps mit abschalten. Deshalb ändere ich vorerst nichts. Warum ich die Crawler überhaupt reinlasse, steht im Beitrag über KI-Crawler und GEO.
Was belegt ist und was offen bleibt
Belegt sind die Ankündigungen vom 30. Oktober, der Text des Entwurfs und die Dokumentation der Crawler bei Google, Microsoft, OpenAI und Anthropic. Offen ist, wann Google und OpenAI die Zeile tatsächlich lesen und wie sie Widersprüche zu ihren eigenen Regeln auflösen. Ebenso offen ist, ob aus dem Entwurf ein Standard wird. Stellungnahmen deutscher Verlegerverbände zu dem Signal habe ich bis zum 1. November nicht gefunden.
Fünf Fragen für deine robots.txt
Bevor du die neue Zeile einträgst, lohnt ein Blick auf diese Punkte.
- 1Nutzen wir NoArchive oder NoCache?Dann betrifft dich die Frist am 1. März 2027. Ab dem 15. Dezember kannst du in den Bing Webmaster Tools übergangsweise das Grounding einstellen, das Training setzt du in der robots.txt.
- 2Wollen wir in Gemini-Antworten auftauchen?Dann sperrt das neue Signal bei Google mehr, als du willst. Training und Gemini Apps lassen sich dort nur gemeinsam erlauben oder sperren.
- 3Welche Crawler-Regeln haben wir schon?Regeln für GPTBot, Google-Extended oder ClaudeBot gelten bei diesen Anbietern weiter. Für das gemeinsame Signal zählen sie nicht.
- 4Was soll frei bleiben?Pressebereich oder Produktdaten gibst du mit „Allow“ in der neuen Gruppe wieder frei.
- 5Wie prüfen wir, ob es wirkt?Bing liest neue Angaben erst beim nächsten Abruf. In den Server-Logs siehst du, wann Bingbot eine Seite zuletzt geholt hat.
Prüf als Erstes, ob deine Website NoArchive oder NoCache nutzt, um Copilot fernzuhalten. Dann trägst du bis zum 1. März 2027 die neuen Angaben ein. Alle anderen haben Zeit. Entscheide vor dem Eintrag, was dir wichtiger ist: kein Training bei Google oder Sichtbarkeit in Gemini. Die Regeln für GPTBot, ClaudeBot und meta-externalagent lässt du stehen, bis die Anbieter das neue Signal wirklich lesen.
Quellen
- Google Search Central Blog: Supporting a shared AI training control for websites
- Google: Übersicht der Google-Crawler (Google-Extended)
- Microsoft Bing Blog: Your content, your choice: clearer preferences for training and grounding
- OpenAI: Making it easier for websites to express AI training preferences
- OpenAI: Overview of OpenAI Crawlers
- Anthropic Help Center: Crawler von Anthropic und robots.txt
- IETF: draft-kelley-aipref-training-preference-signal-00
- IETF-Mailingliste: Ankündigung von Kevin Kelley
- Search Engine Journal: Google, Microsoft & OpenAI Plan To Honor Shared AI Training Opt-Out
- Search Engine Journal: Google Search Console AI Reports Rolled Out Worldwide
- § 44b UrhG: Text und Data Mining
- EU-Kommission: The General-Purpose AI Code of Practice
Alle Quellen zuletzt geprüft am 1. November 2026.