ChatGPT unter dem DSA: Warum das Werbearchiv jetzt doch kommt
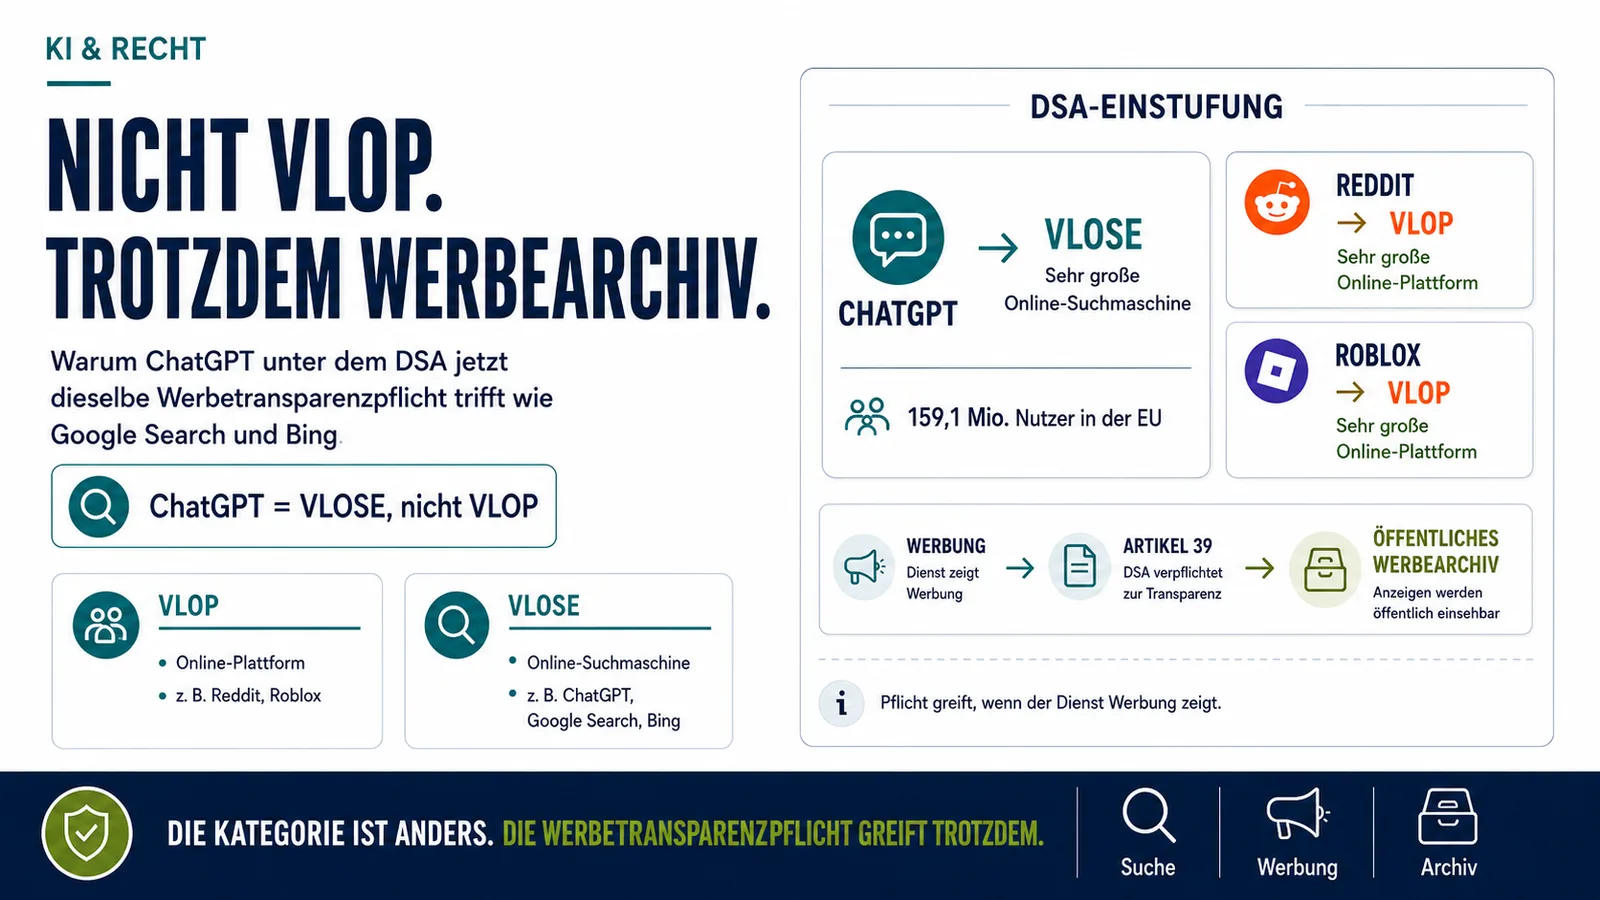
Am Montag hat die Europäische Kommission ChatGPT, Reddit und Roblox benannt. Für ChatGPT ist das die Einstufung als sehr große Online-Suchmaschine, in derselben Kategorie wie Google Search und Bing. Reddit und Roblox sind sehr große Plattformen. Diese Unterscheidung geht in fast jeder Meldung unter, und sie ist der Punkt, an dem sich entscheidet, was OpenAI ab Januar tun muss.
Was am Montag entschieden wurde
Die amtliche Liste der Kommission trägt seit dem 31. August drei neue Einträge. ChatGPT steht dort mit 159,1 Millionen durchschnittlichen monatlichen Nutzern in der EU, benannt als sehr große Suchmaschine. Reddit kommt auf 57,2 Millionen, Roblox auf 46,6 Millionen, beide als sehr große Plattformen. Die Schwelle liegt bei 45 Millionen.
Jene 159,1 Millionen sind keine Schätzung der Kommission. OpenAI hat sie selbst gemeldet, für den Zeitraum bis Ende März, und zwar ausdrücklich für die Suchfunktion von ChatGPT. Genau diese Zahl stand vor einer Woche noch in meinem Beitrag zu ChatGPT Ads als Beleg dafür, dass die Benennung kommen dürfte.
Warum eine Suchmaschine und kein Chatbot: Die Kommission nennt ChatGPT einen hybriden Dienst. Er antwortet auf Anfragen und durchsucht dafür unter anderem das Web. Die vollständige Entscheidung mit der genauen Abgrenzung ist noch nicht veröffentlicht, in der Liste steht dazu bislang nur ein Vermerk.
Warum das Werbearchiv jetzt doch kommt
In meinem Beitrag vom 25. August stand dieser Satz: Ohne Benennung greift Artikel 39 des Digital Services Act nicht, und damit besteht keine Pflicht zu einem öffentlichen Werbearchiv. Das war am 25. August richtig. Seit Montag ist es überholt.
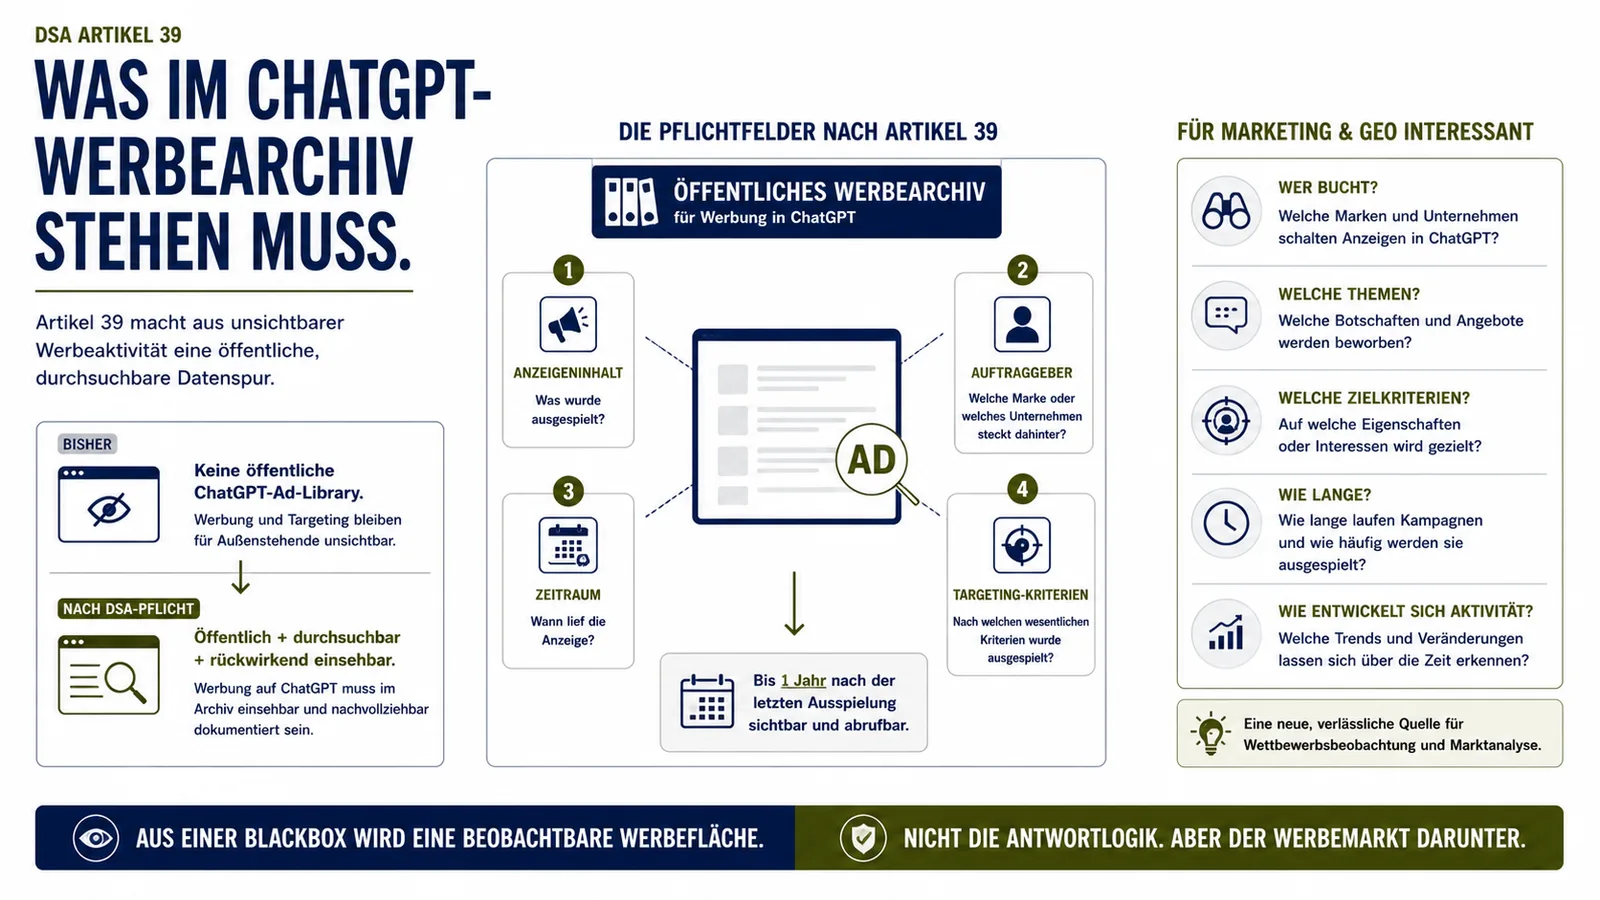
Der Verordnungstext ist an dieser Stelle eindeutig. Artikel 39 Absatz 1 beginnt mit den Anbietern sehr großer Online-Plattformen oder sehr großer Online-Suchmaschinen, die Werbung auf ihren Oberflächen zeigen. Beide Kategorien, nicht nur Plattformen. Wer darunterfällt, muss ein öffentliches und durchsuchbares Archiv führen. Hinein gehören der Inhalt der Anzeige, der Auftraggeber, der Zeitraum und die wesentlichen Targeting-Kriterien, und zwar bis ein Jahr nach der letzten Ausspielung.
Die Pflicht hängt an einer Bedingung: Der Dienst muss Werbung zeigen. Seit dem 24. August tut ChatGPT das in Deutschland. Damit ist die Lücke, die ich vor einer Woche beschrieben habe, absehbar geschlossen.
Praktisch heißt das: Wer wissen will, welche Marken in ChatGPT-Antworten Anzeigen buchen und auf welche Kriterien sie zielen, bekommt dafür eine Quelle. Was Meta und Google längst führen, bekommt damit auch OpenAI.
Was sonst gilt, und ab wann genau
Neben der Werbetransparenz greifen die übrigen Pflichten aus Abschnitt 5. Die wichtigsten drei: eine jährliche Bewertung systemischer Risiken aus Design und Funktionsweise des Dienstes samt algorithmischer Systeme nach Artikel 34. Angemessene Gegenmaßnahmen für die gefundenen Risiken nach Artikel 35. Und Transparenzberichte im Halbjahrestakt nach Artikel 42.
Dazu kommt Artikel 38: Wer Empfehlungssysteme einsetzt, muss für jedes davon eine Option ohne Profiling anbieten. Auch das gilt laut Wortlaut für Suchmaschinen. Welche Bestandteile von ChatGPT als Empfehlungssystem gelten, steht allerdings nirgends, und ohne die veröffentlichte Entscheidung ist das nicht zu beantworten.
Beim Datum wird es ungenau. Die Kommission schreibt vier Monate, also bis Januar 2027. Artikel 33 Absatz 6 knüpft die Frist aber nicht an die Pressemitteilung, sondern an die Mitteilung der Entscheidung an den Anbieter. Wann OpenAI sie erhalten hat, ist nicht öffentlich. Ein genauer Kalendertag lässt sich daraus heute nicht ableiten.
Zuständig ist die Kommission selbst. Artikel 56 Absatz 2 gibt ihr die ausschließliche Aufsicht über genau diesen Pflichtenblock. Der Rahmen für Bußgelder liegt bei bis zu 6 Prozent des weltweiten Jahresumsatzes.
Drei Dinge, die gerade überall falsch stehen
**ChatGPT ist keine VLOP.** Die Abkürzung steht für sehr große Online-Plattform, und das sind Reddit und Roblox. ChatGPT ist eine VLOSE, eine sehr große Suchmaschine. Der Themenscanner, der mir dieses Thema vorgeschlagen hat, hat es dreimal falsch geschrieben, und in vielen Meldungen steht es genauso.
**Die Frist ist nicht Ende Dezember.** In der Mitteilung der Kommission steht Januar 2027. Auch Ende Januar steht nirgends. Wer ein konkretes Datum nennt, hat es sich ausgedacht.
**Nicht jeder Chat ist jetzt eine Suchmaschine.** Benannt ist der Dienst ChatGPT, gezählt wurden die Nutzer der Suchfunktion. Ob ein Chat ohne Websuche außerhalb der Pflichten liegt, sagt die Kommission bisher nicht. Beide einfachen Antworten sind falsch.
Reddit in KI-Antworten: Die Zahlen sagen etwas anderes
Der naheliegende GEO-Winkel lautet: Reddit ist eine der häufigsten Quellen in KI-Antworten, jetzt kommen Moderationspflichten, also verschiebt sich die Quellenlage. Diese Geschichte trägt nicht, und zwar aus zwei Gründen.
Erstens ist der Anteil ohnehin sprunghaft. Promptwatch hat gemessen, dass Reddit zwischen dem 18. Juli und dem 7. August rund 3,8 Prozent aller Zitate in ChatGPT Search stellte. Vom 14. bis 17. August waren es noch 0,5 Prozent. Die Firma schreibt allerdings selbst dazu, ein Fehler bei der Datenerhebung lasse sich nicht ausschließen.
Der Absturz ist trotzdem kein Einzelfall. Semrush hat 2025 dasselbe Muster gesehen, über 13 Wochen und 230.000 Prompts. Anfang August tauchte Reddit in knapp 60 Prozent der ChatGPT-Antworten auf. Mitte September waren es rund 10 Prozent. Diese Zahl misst etwas anderes als die von Promptwatch, nämlich den Anteil der Antworten mit mindestens einer Reddit-Quelle, nicht den Anteil an allen Zitaten. Vergleichbar sind die beiden Werte deshalb nicht, wohl aber die Richtung.
Zweitens stimmt die Reihenfolge nicht. Der Einbruch begann am 14. August, gut zwei Wochen vor der Benennung und Monate vor dem Beginn der neuen Pflichten. Wer das dem DSA zuschreibt, verwechselt Zeitpunkt mit Ursache.
Der belastbare Schluss ist unspektakulärer. Reddit kann in einem System sehr wichtig sein und innerhalb von Tagen fast verschwinden, ohne dass jemand eine Regel geändert hat.
Was ich in Projekten ändere
Für meine Kunden ändert sich durch die Benennung erst einmal nichts. Die Pflichten treffen OpenAI und Reddit, nicht die Teams, die dort sichtbar werden wollen. Niemand braucht wegen des DSA einen Beauftragten für Reddit-Beiträge oder eine eigene Risikobewertung.
Geändert habe ich, wann wir messen. Vor Januar halten wir für die wichtigsten Fragen fest, welche Quellen die drei großen Systeme zitieren. Und wie viel davon auf Reddit, Fachmedien oder die eigene Seite entfällt. Das verlangt keine Pflicht. Wir wollen später auseinanderhalten können, was am Modell liegt und was an einer Auflage.
Beim medienrechtlichen Vorstoß der Landesmedienanstalten lief es genauso. Ein Bescheid kommt, alle wollen sofort etwas umstellen. Sinnvoll war am Ende nur, den Ausgangszustand zu dokumentieren.
Womit ich diese Woche anfangen würde
Stell deine zehn wichtigsten Fragen in den drei großen Systemen und notiere jede zitierte Quelle mit Datum. Das ist deine Ausgangslage vor Januar.
Wenn du Anzeigen in ChatGPT buchst oder es vorhast, setz dir eine Erinnerung auf Januar. Ab dann sollte das Werbearchiv erscheinen, und dort steht dann auch, was deine Wettbewerber buchen.
Und wenn du über die Einstufung schreibst oder sprichst: sehr große Suchmaschine, nicht Plattform. Diesen einen Satz richtig zu haben, unterscheidet dich diese Woche von fast allen anderen.