Brave verkauft seinen Suchindex an KI: Warum robots.txt hier nicht greift
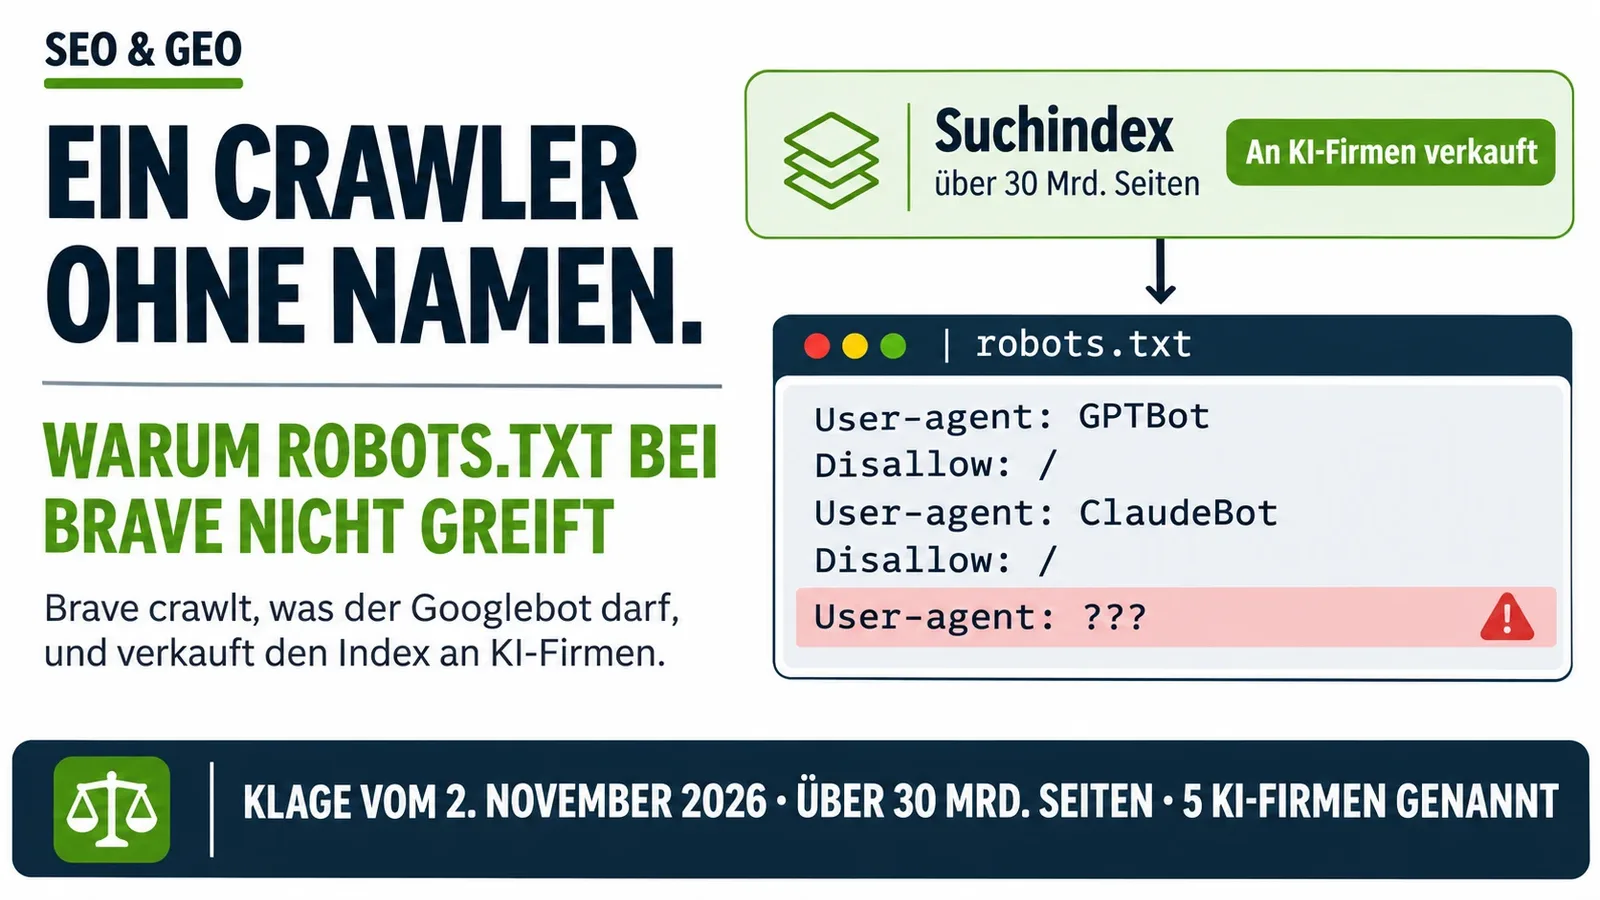
Am 2. November haben die New York Times und drei weitere US-Zeitungen Brave Software verklagt, die Firma hinter dem Browser und der Suchmaschine Brave. Der Vorwurf: Brave habe für seinen Suchindex über 30 Milliarden Webseiten kopiert und den Zugang an KI-Firmen verkauft. Für Websitebetreiber steckt in der Klage eine zweite Nachricht. Braves Crawler lässt sich in der robots.txt nicht ansprechen, weil er keinen eigenen Namen trägt. Wer Brave aussperren will, sperrt Google mit aus.
Was die Verlage vorwerfen
Eingereicht wurden die Klagen beim Bundesgericht für den südlichen Bezirk von New York. Die New York Times klagt allein, Daily News, Chicago Tribune und Orlando Sentinel klagen gemeinsam. Beide Klagen stützen sich auf fünf Punkte: direkte und mittelbare Urheberrechtsverletzung, Haftung für Verletzungen durch andere, Umgehung technischer Schutzmaßnahmen und ungerechtfertigte Bereicherung. Laut der Klageschrift der Times zielen die Vorwürfe unter anderem auf drei Produkte: den Suchindex, den Brave über eine Schnittstelle verkauft, die KI-Antworten von „Ask Brave“ und eine Browser-Einstellung namens „Paywall blocker“, mit der sich Bezahlschranken umgehen lassen.
Die Zahl von über 30 Milliarden Seiten stammt von Brave selbst, die Klage zitiert sie von Braves KI-Seite. Als Abnehmer nennt die Times Anthropic, Perplexity, Mistral, xAI und Cohere. Verklagt ist keine dieser Firmen. Für Anthropic stützt sich die Klage auf einen Blogbeitrag von Brave aus dem Jahr 2023, laut dem Anthropic die Schnittstelle nutzte, um Claude 2 zu trainieren. Brave hatte bis zum 4. November weder öffentlich noch vor Gericht geantwortet. Mit News Corp, dem Verlag des Wall Street Journal, streitet Brave schon länger. Brave klagte im März 2025 auf die Feststellung, dass sein Indexieren erlaubt ist, News Corp antwortete im Juli 2026 mit einer Gegenklage.
Ein Crawler ohne Namen
Ein Crawler meldet sich bei einer Website normalerweise mit einer Kennung, dem User Agent. Über diese Kennung regelt die robots.txt, wer was lesen darf. Laut Braves Hilfeseite meldet sich der Brave-Crawler nicht mit eigener Kennung. Brave begründet das damit, nicht von Websites ausgesperrt zu werden, die nur Google crawlen lassen. Stattdessen übernimmt Brave die Erlaubnisse des Googlebot: Was der Googlebot nicht crawlen darf, crawlt Brave auch nicht. Hinweise auf Seiten liefern zusätzlich Brave-Nutzer, die freiwillig Daten aus ihrem Browser teilen.
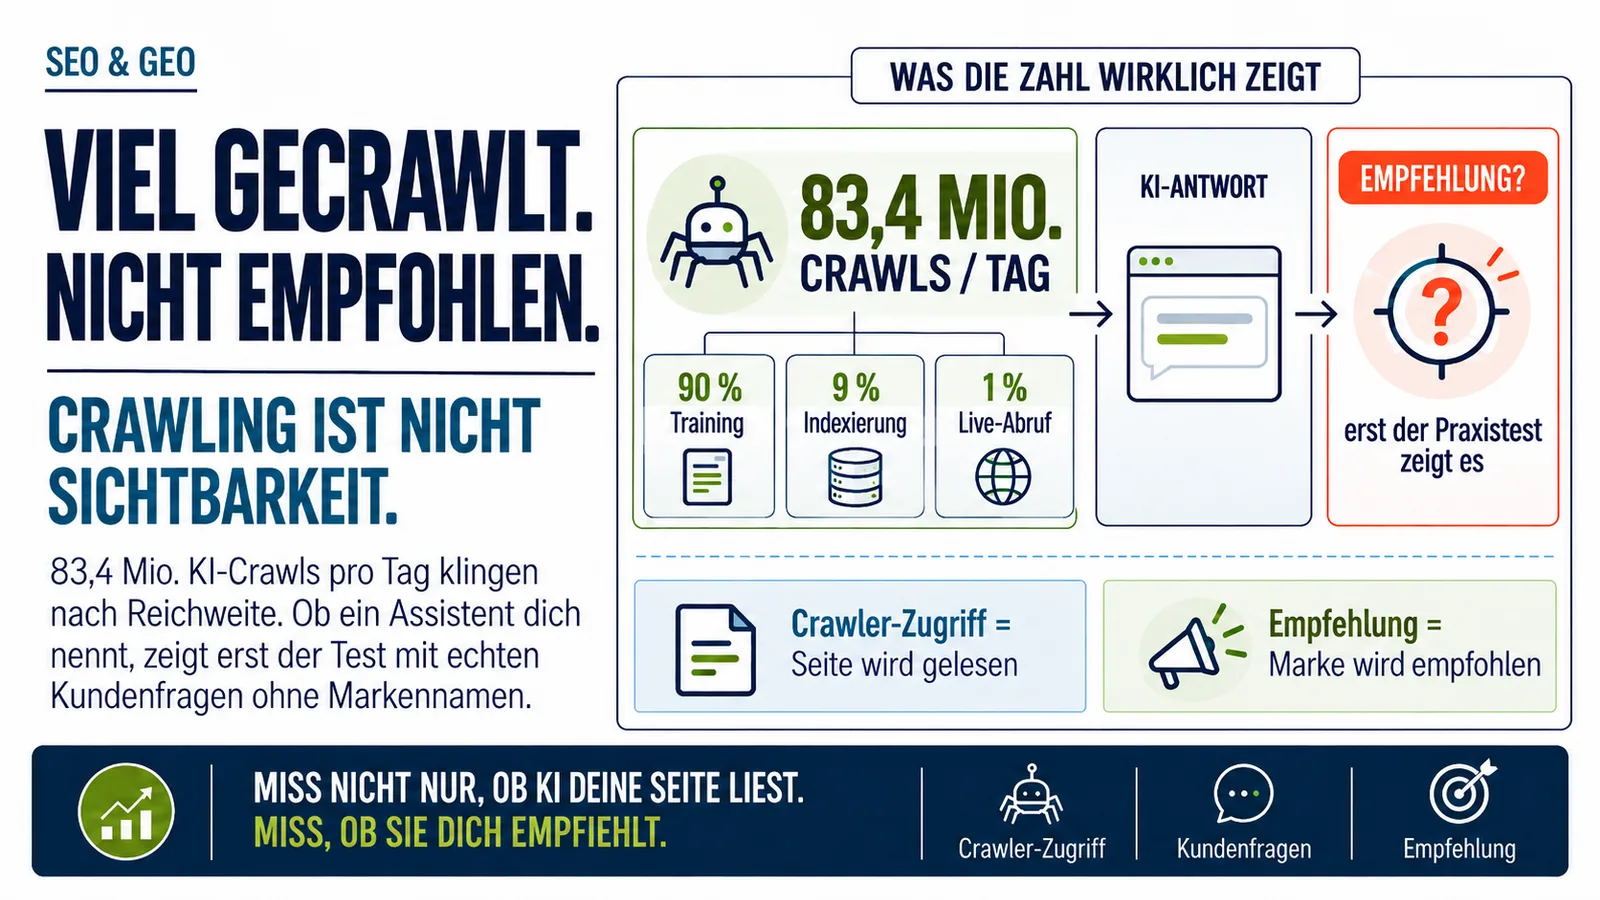
Genau hier setzt die Times an. Brave habe kopiert, ohne sich zu erkennen zu geben und ohne Websitebetreibern einen Weg zu bieten, den Crawler zu sperren. Bei anderen Anbietern gibt es diesen Weg. OpenAI und Anthropic veröffentlichen die Namen ihrer Crawler, eine Website kann den einen zulassen und den anderen sperren. Bei Brave fehlt dieser Hebel. Wie oft KI-Crawler eine Seite besuchen und was das über ihre Sichtbarkeit verrät, steht im Beitrag über KI-Crawler und GEO.
Was du Brave sagen kannst
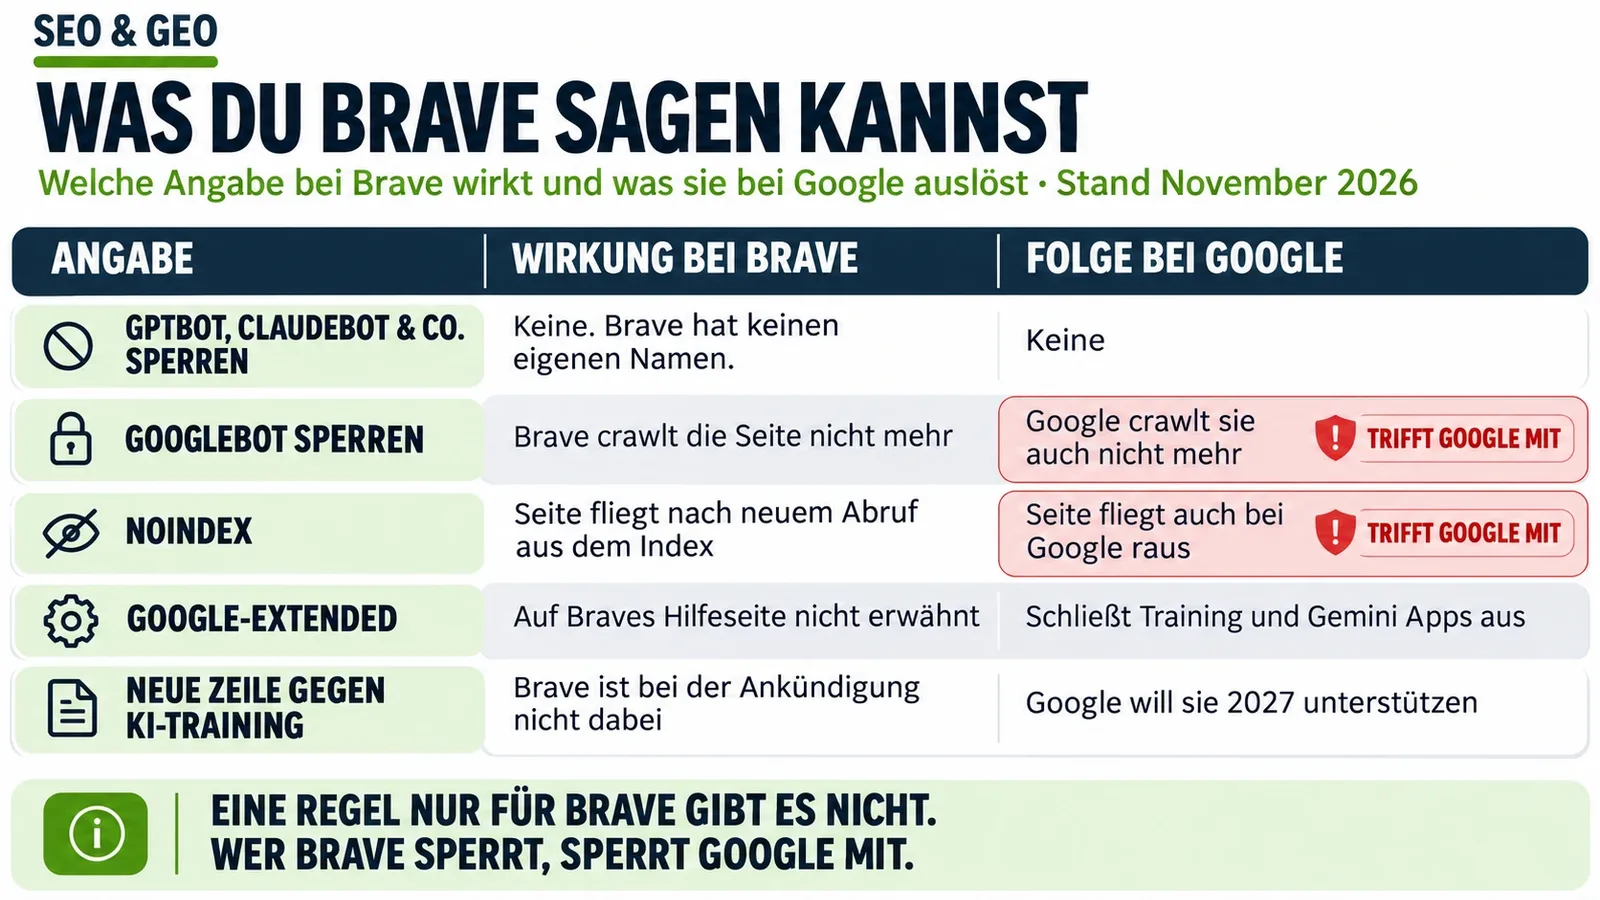
Wer Brave heute steuern will, hat zwei Hebel, und beide treffen Google mit. Sperrt die robots.txt den Googlebot, bleiben Google und Brave draußen. Aus dem Index nimmt das eine Seite laut Brave aber nicht, die robots.txt nutzt Brave dafür ausdrücklich nicht. Dafür gibt es den zweiten Hebel, das Meta-Tag noindex. Nach dem Eintrag muss Brave die Seite neu abrufen, das lässt sich über ein Formular anstoßen. Google nimmt eine Seite mit noindex ebenfalls aus der Suche.
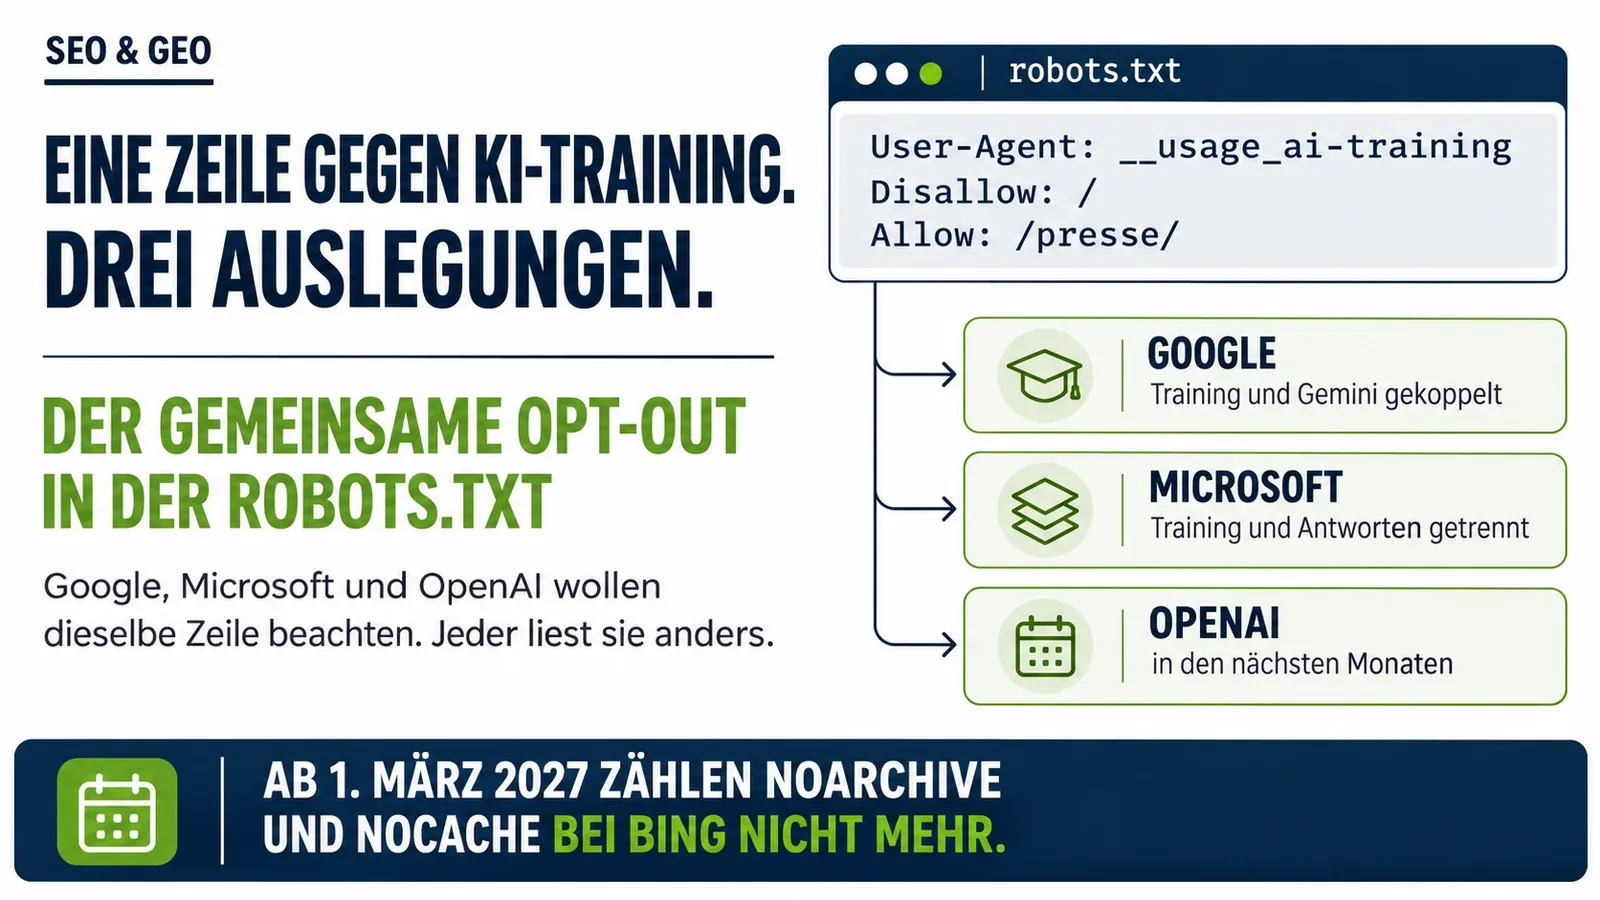
Für die neuen Signale gegen KI-Training gibt es bei Brave keine Zusage. Google-Extended ist eine Angabe in der robots.txt, mit der Websites das Training bei Google ausschließen. Braves Hilfeseite erwähnt sie nicht. Google, Microsoft und OpenAI haben am 30. Oktober eine gemeinsame Zeile gegen KI-Training angekündigt. Bei dieser Ankündigung ist Brave nicht dabei. Was diese Zeile bewirkt und für wen sie gilt, steht im Beitrag über den gemeinsamen KI-Opt-out.
Warum KI-Firmen bei Brave einkaufen
Eine eigene Websuche aufzubauen kostet viel Geld, und seit dem 11. August 2025 gibt es eine große Quelle weniger: Microsoft hat an diesem Tag seine Bing-Schnittstellen für die Websuche abgeschaltet. Brave verkauft den Zugang zum eigenen Index, der Tarif „Search“ kostet laut Braves Preisseite 5 Dollar pro 1.000 Anfragen. Ergebnisse speichern oder fürs Training nutzen darf nur, wer einen Tarif mit Speicherrechten bucht. Ein Angebot namens „LLM Context“ liefert laut Klage Textausschnitte in einer Form und Länge, die zu einem Sprachmodell passt, sodass die KI-Firma die Seiten nicht mehr selbst abrufen muss.
Wie nah das am Alltag ist, zeigt Claude, mit dem ich viele meiner Automationen baue. Anthropic führt Brave Search seit dem 19. März 2025 als Dienstleister. Der Entwickler Simon Willison stellte damals fest, dass die zehn Quellen einer Websuche in Claude genau den Treffern bei Brave entsprachen. Ob Claude heute noch über Brave sucht, konnte ich an keiner Primärquelle prüfen. Auf Braves Seite stehen als Kunden unter anderem Cohere, Mistral und You.com. Welche Quellen KI-Antworten tatsächlich zitieren, lässt sich nur lückenhaft messen, wie der Beitrag über GEO-Tracking zeigt.
Der Selbsttest
Ob die eigene Seite im Index steckt, zeigt eine einfache Suche. Auf search.brave.com gibst du site: und deine Domain ein, also etwa site:beispiel.de. Was dort erscheint, liegt in dem Index, den Brave über die Schnittstelle verkauft. Achte auch auf die Vorschautexte. Sie zeigen, welche Fassung deiner Seite Brave gespeichert hat.
Was ich bei meiner Seite gefunden habe
Ich habe den Test am 7. November mit tim-schoster.de gemacht. Von rund 60 Seiten meiner Website zeigt Brave genau zwei: die Startseite und meinen Beitrag über ChatGPT-Werbung. Bei dem Beitrag stehen noch der Seitenpfad meiner alten Website und im Vorschautext Schlagzeilen aus einem Nachrichtenticker vom August. Brave liefert also eine gespeicherte Kopie, die Wochen alt ist. Ob der Index mehr von meiner Seite enthält, als die Suche zeigt, lässt sich von außen nicht sehen. Unter „Nutzer fragen auch“ tauchen dafür Fragen aus meinem FAQ auf, etwa „Wie läuft ein Projekt bei dir ab?“.
Gesperrt wird bei mir nichts. Meine robots.txt lässt alle Crawler zu, weil ich in KI-Antworten auftauchen will. Mein Problem ist eher, dass Brave zu wenig von mir kennt. Falls Claude seine Websuche weiter über Brave abwickelt, findet es dort von meinen Blogartikeln derzeit genau einen. Für mich lohnt es sich deshalb, die wichtigsten Artikel über Braves Formular zum Abruf einzureichen. Ein Verlag mit Bezahlschranke rechnet anders. Er kann bei Brave heute nur wählen, ob er Brave und Google zulässt oder beide aussperrt.
Was Verlage abwägen
Die meisten großen Nachrichtenseiten haben sich längst entschieden. Laut einer Auswertung von BuzzStream vom Januar 2026 sperren 79 Prozent der 100 größten Nachrichtenseiten in den USA und Großbritannien mindestens einen Trainings-Crawler. Diese Sperren richten sich an Crawler mit Namen wie GPTBot oder ClaudeBot. Bei Brave greifen sie nicht.
In Deutschland erlaubt § 44b UrhG das automatische Auswerten frei zugänglicher Inhalte, solange der Rechteinhaber das nicht maschinenlesbar vorbehalten hat. Das OLG Hamburg hat im Dezember 2025 entschieden, dass der Rechteinhaber darlegen muss, dass sein Vorbehalt zum Zeitpunkt der Nutzung maschinenlesbar war. Die Revision zum Bundesgerichtshof ist zugelassen. Wie ein Vorbehalt einen Crawler ohne Namen erreichen soll, hat noch kein Gericht geklärt. Dieser Beitrag ersetzt keine Rechtsberatung.
Was belegt ist und was offen bleibt
Belegt sind die Klagen, ihre Anspruchsgrundlagen und Braves eigene Angaben zu Crawler, Index und Schnittstelle. Was die Verlage Brave vorwerfen, hat noch kein Gericht geprüft. Offen ist, welche der genannten KI-Firmen den Index heute nutzen und wofür: für Antworten in Echtzeit oder fürs Training. Brave hat sich zu den Klagen bisher nicht geäußert.
Fünf Fragen zu Brave und deiner Website
Diese Fragen helfen, die eigene Website gegen Braves Regeln zu prüfen.
- 1Steckt meine Seite im Brave-Index?Gib auf search.brave.com site: und deine Domain ein. Was dort erscheint, liegt im Index, den Brave über seine Schnittstelle verkauft.
- 2Kann ich nur Brave sperren?Nein. Braves Crawler hat keine eigene Kennung und folgt den Regeln für den Googlebot. Eine Sperre für den Googlebot trifft deshalb immer beide.
- 3Wie nehme ich eine Seite aus dem Index?Mit dem Meta-Tag noindex. Danach stößt du über Braves Formular einen neuen Abruf an. Google nimmt die Seite dann ebenfalls aus der Suche.
- 4Hilft eine Sperre für GPTBot oder ClaudeBot?Sie gilt nur für diese Crawler. Inhalte, die KI-Firmen über Braves Schnittstelle beziehen, erreicht sie nicht.
- 5Was tun, wenn Brave eine alte Fassung zeigt?Reich die Seite über Braves Formular zum neuen Abruf ein. Für Seiten, die es nicht mehr gibt, nennt Brave zusätzlich die Adresse not-found@brave.com.
Mach den Test mit deiner Domain und schau dir die Vorschautexte an. Fehlen wichtige Seiten, reichst du sie über Braves Formular ein. Entscheide dann bewusst: Sichtbarkeit bei Brave und in den KI-Antworten, die auf Braves Index zugreifen, oder noindex mit allen Folgen für Google. Für die meisten Unternehmensseiten spricht viel dafür, offen zu bleiben. Verlage mit Bezahlinhalten sollten das Verfahren in New York verfolgen.
Quellen
- New York Times Company v. Brave Software: Klageschrift vom 2. November 2026 (PDF)
- Brave: Brave Search Crawler (Hilfeseite)
- Brave: Brave Search API (Tarife und Speicherrechte)
- PPC Land: New York Times and three papers sue Brave over AI answers and ad blocking
- Search Engine Journal: Brave Sells Its Search Index To AI, And Your Website Is Probably In It
- Semafor: News Corp accuses search engine Brave of AI copyright infringement
- Bloomberg Law: News Corp., Search Engine Firm End Website-Scraping Suit
- TechCrunch: Anthropic appears to be using Brave to power web searches for its Claude chatbot
- Simon Willison: Anthropic used Brave
- Windows Central: Bing Search APIs werden abgeschaltet
- Search Engine Journal: Most Major News Publishers Block AI Training & Retrieval Bots (BuzzStream)
- Kanzlei Dr. Bahr: OLG Hamburg zum LAION-Fall, Urteil vom 10.12.2025, Az. 5 U 104/24
Alle Quellen zuletzt geprüft am 7. November 2026.