GPT-6 Astra: Was OpenAIs Floskelliste über das eigene Modell verrät
OpenAI hat zum neuen Modell GPT-6 Astra eine Anleitung fürs Prompten veröffentlicht. Darin steht eine Liste von Wörtern und Satzmustern, die das Modell vermeiden soll. Ein Hersteller veröffentlicht damit die Erkennungsmerkmale seines eigenen Produkts. Für deutsche Texte greift die Liste allerdings zu kurz.
Was auf der Liste steht
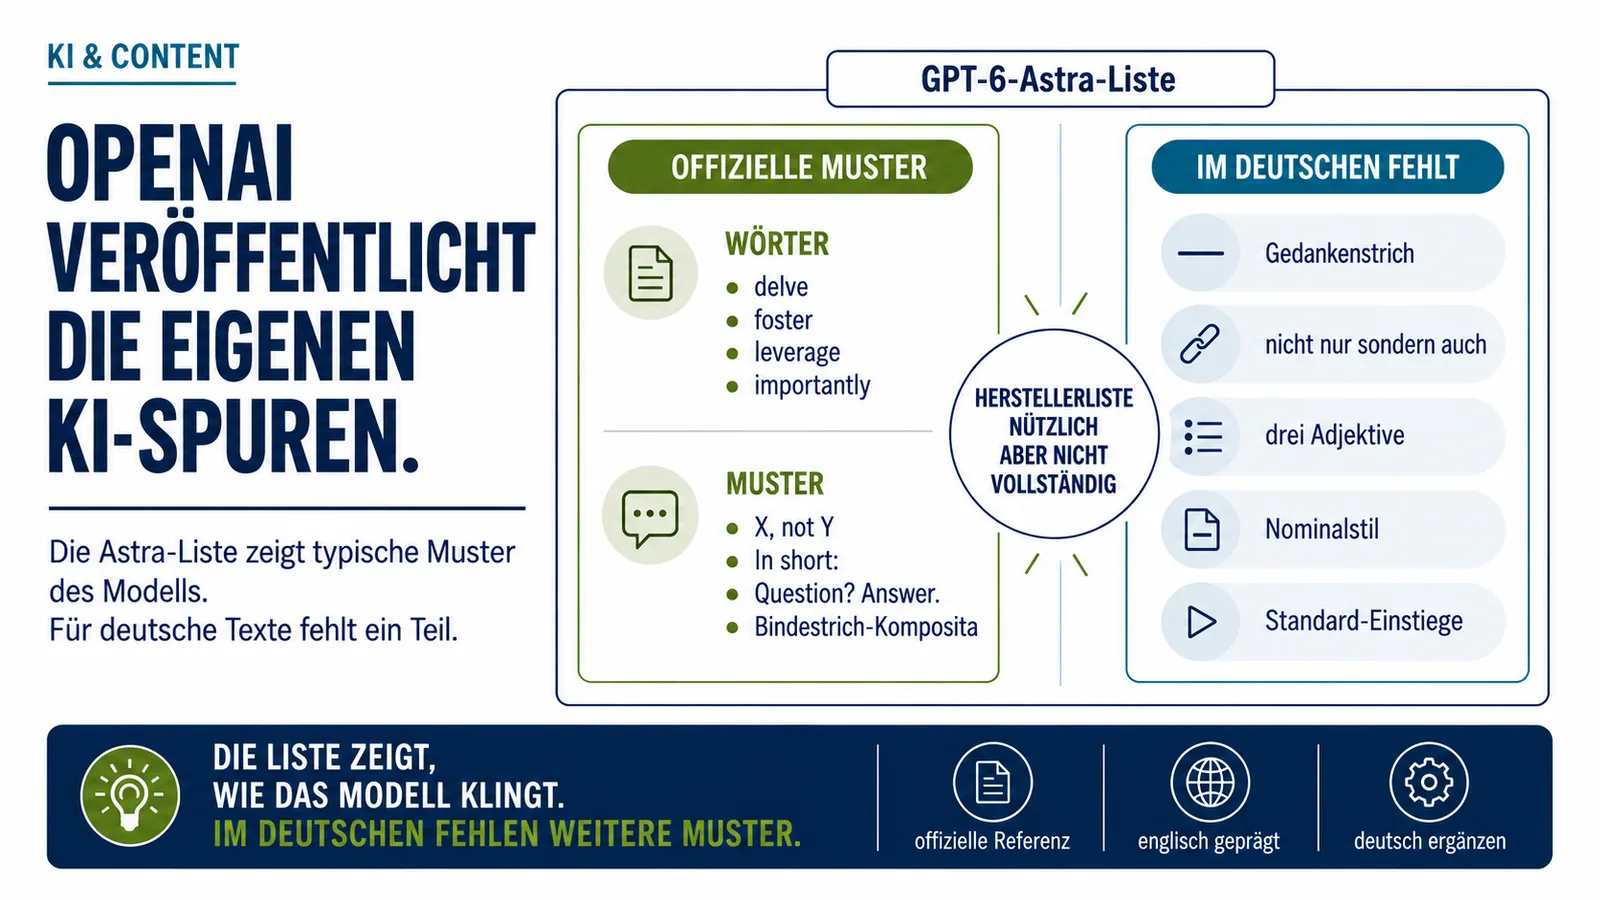
Die Anleitung nennt zwei Sorten von Verboten. Zuerst einzelne Wörter: „delve“, „foster“, „leverage“, „it’s worth noting“, „importantly“.
Interessanter ist die zweite Sorte, weil sie über Vokabeln hinausgeht. Zusammenfassungs-Schlusssätze wie „In short:“ oder „The simplest mental model is:“ sollen verschwinden. Ebenso die Kontrastformel „X, not Y“ samt ihrer ausformulierten Variante „This isn’t about X. It’s about Y.“ Dazu erfundene Bindestrich-Komposita, wofür OpenAI zwei eigene Beispiele liefert: „exact-head checks“ und „editorial-row layouts“. Die rhetorische Frage mit nachgeschobener Antwort steht ebenfalls darauf, im Original „Question? Answer.“
Die Begründung passt in einen Halbsatz. Der Abschnitt beginnt mit der Aufforderung, Fachjargon und abgegriffene Phrasen zu reduzieren.
Gepflegt wird die Liste außerdem. The Decoder zitierte sie am 5. September noch mit „Conclusion:“ als erstem Beispiel, dazu „promote“, „what’s important is“ und „really/truly“. In der Dokumentation steht heute „Bottom Line:“, und die Wortauswahl dahinter ist ausgetauscht. Zwei Tage, eine Überarbeitung.
Warum das ein Eingeständnis ist
Ein Verbot richtet sich gegen etwas, das ohnehin passiert. Niemand verbietet einem Sprachmodell, Gedichte auf Altgriechisch zu schreiben. Die Liste beschreibt also, wie das Modell formuliert, wenn man es lässt. Darin liegt ihr Informationsgehalt.
Für Content-Teams ist das brauchbar. Wer bisher darüber gestritten hat, ob ein Text nach KI klingt, hat jetzt eine Referenz vom Hersteller selbst. Das wiegt in einer Redaktionskonferenz schwerer als ein Bauchgefühl.
Meine Listen laufen seit Monaten mit
In drei Systemen, die ich betreibe, steht so eine Liste im Prompt. Unterschiedlich ausführlich, je nachdem, was dort entsteht.
Am längsten ist sie im Redaktionssystem für die Agentur PR Profis. Dort heißt es: keine Formulierungen nach dem Muster „Nicht X, sondern Y“. Keine Floskeln wie „In der heutigen Zeit“, „In einer Welt, in der“, „Es ist wichtig zu beachten“, „Zusammenfassend lässt sich sagen“. Keine vagen Sätze wie „Dies kann hilfreich sein“ oder „Ein guter Weg ist“. Keine drei Adjektive hintereinander. Keine aufgeblasenen Begriffe wie „ganzheitlich“, „umfassend“, „revolutionär“, „zukunftsweisend“. Wörtlich im Prompt steht auch: keine Gedankenstrich-Orgie.
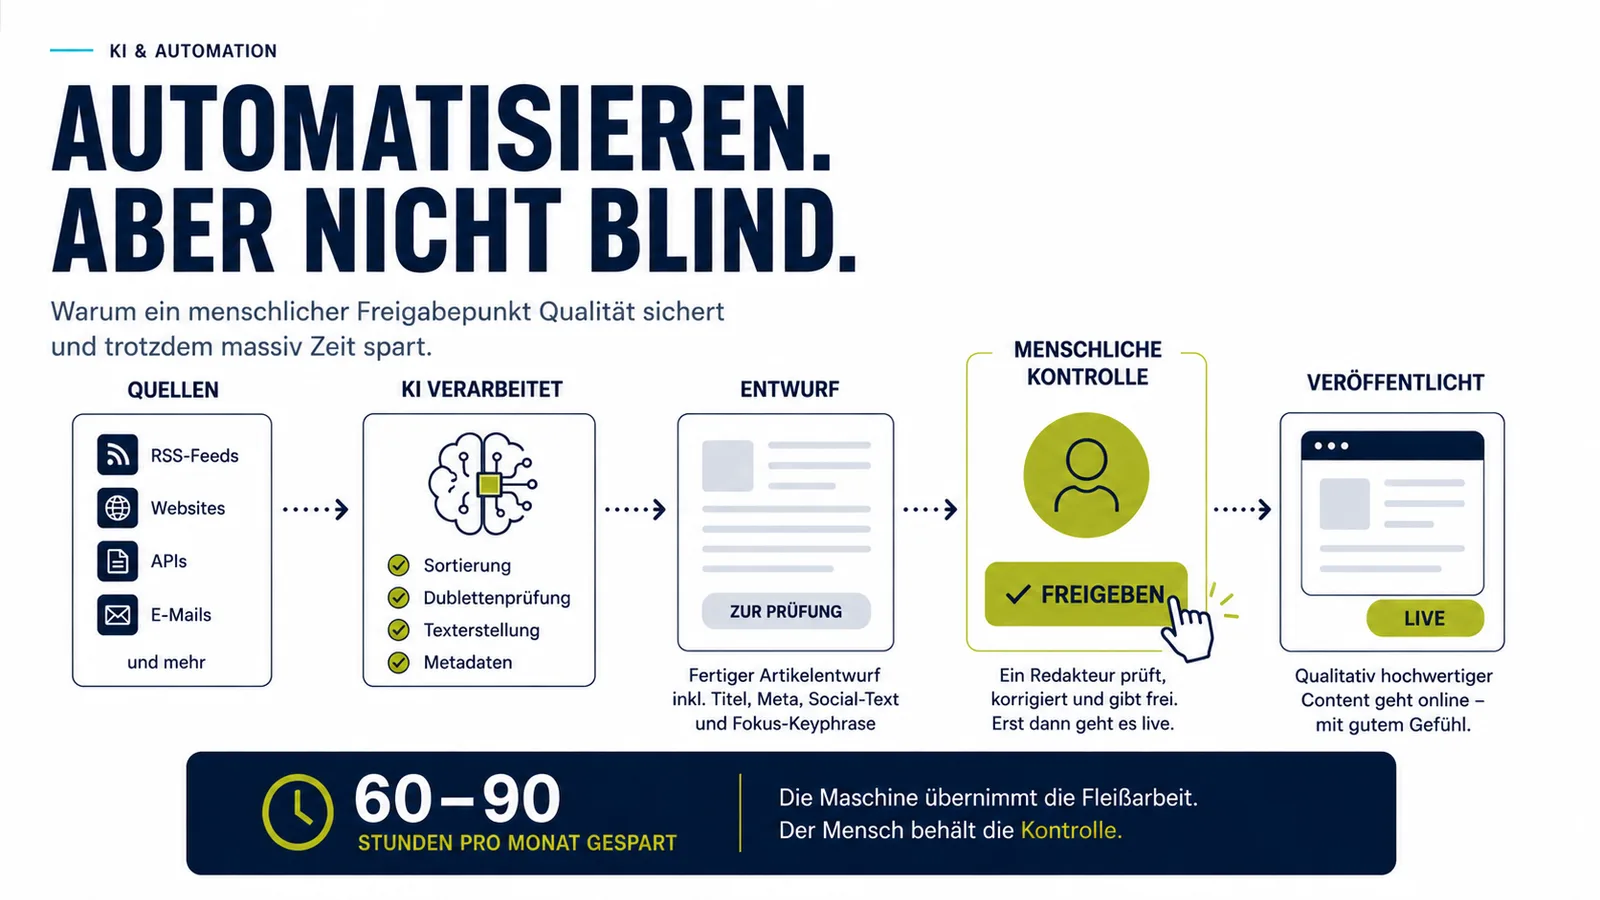
Im Sportportal FCBinside fällt sie knapper aus, weil dort Nachrichten entstehen und keine Fachbeiträge: keine künstlichen Formulierungen, kein KI-typischer Fülltext, möglichst viele Verben statt Substantivierungen. Was daraus wird, ist ein Entwurf. Redigiert und veröffentlicht wird er von der Redaktion.
Mein eigener KI-News-Scanner kommt mit der kürzesten Fassung aus, dort sind es nur Meldungen von drei Sätzen. Verboten sind Gedankenstriche, die Wörter ganzheitlich, innovativ, sauber, präzise, nahtlos, wegweisend, eintauchen und umfassend, die Konstruktion „nicht nur, sondern auch“, drei gestapelte Adjektive und mehr als eine Antithese.
Fünf Punkte stehen auf beiden Seiten, obwohl die Listen nichts voneinander wissen. Am deutlichsten die Antithese: OpenAI verbietet „X, not Y“, bei mir steht „Nicht X, sondern Y“. Dieselbe Konstruktion, zwei Sprachen, gleiche Diagnose. Dazu die Schlusssätze, die Weichmacher, die vagen Halbaussagen und die aufgeblasenen Wörter. „Delve“ und „eintauchen“ sind dasselbe Wort.
Fünf Muster, die im Deutschen fehlen
Der Gedankenstrich ist der auffälligste Fall. Im Deutschen verrät er einen Text schneller als jedes Wort. Auf OpenAIs Liste taucht er nicht auf, und das hat einen Grund: Im Englischen ist er ein normales Satzzeichen. So normal, dass OpenAI ihn im eigenen Regeltext verwendet. Das Verbot der Kontrastformel lautet dort „X, not Y“ or „X—not Y“. Genau dieses Zeichen in der zweiten Variante lässt einen deutschen Text auffliegen.
Für „nicht nur, sondern auch“ gibt es kein Gegenstück auf der Liste. Drei gestapelte Adjektive stehen dort nicht. Der Nominalstil fehlt ganz, also „unter Zuhilfenahme von“ statt „mit“, weil das Deutsche ihn erlaubt und das Englische ihn kaum hergibt.
Am wichtigsten ist der Anfang. OpenAI verbietet Schlusssätze und sagt nichts über Einstiege. „In der heutigen Zeit“ und „In einer Welt, in der“ sind im Deutschen die verlässlichsten Anzeichen überhaupt. In meinen Prompts stehen sie ganz oben, bei OpenAI kommen sie nicht vor.
Wer die Liste eins zu eins in einen deutschen Prompt kopiert, bekommt also die halbe Wirkung.
Wie oft das wirklich vorkommt
Dass hinter der Liste etwas Reales steckt, lässt sich belegen. Eine Gruppe um Dmitry Kobak hat in Science Advances den Wortschatz von 15 Millionen medizinischen Kurzfassungen aus den Jahren 2010 bis 2024 verglichen. Die Methode stammt aus der Epidemiologie. Sie misst, wie oft ein Wort häufiger auftaucht, als zu erwarten wäre.
Mindestens 13,5 Prozent aller Kurzfassungen aus 2024 sind demnach durch ein Sprachmodell gelaufen, in einzelnen Fachgebieten bis zu 40 Prozent. Der Effekt auf die Wissenschaftssprache übertrifft den der Corona-Jahre.
Einen Witz haben sich die Forscher dabei erlaubt: Das auffälligste Markerwort steht in ihrem eigenen Titel, „Delving into LLM-assisted writing“.
Die Wörter sind also wirklich Spuren. Nur taugen sie schlecht als Beweis.
Wen die Erkennung trifft
Eine Gruppe um Weixin Liang in Stanford hat sieben verbreitete Erkennungsdienste getestet und die Ergebnisse in Patterns veröffentlicht. Bei Aufsätzen von US-Achtklässlern arbeiteten die Dienste nahezu fehlerfrei. Von den TOEFL-Aufsätzen der Nicht-Muttersprachler stuften sie mehr als die Hälfte fälschlich als KI-erzeugt ein.
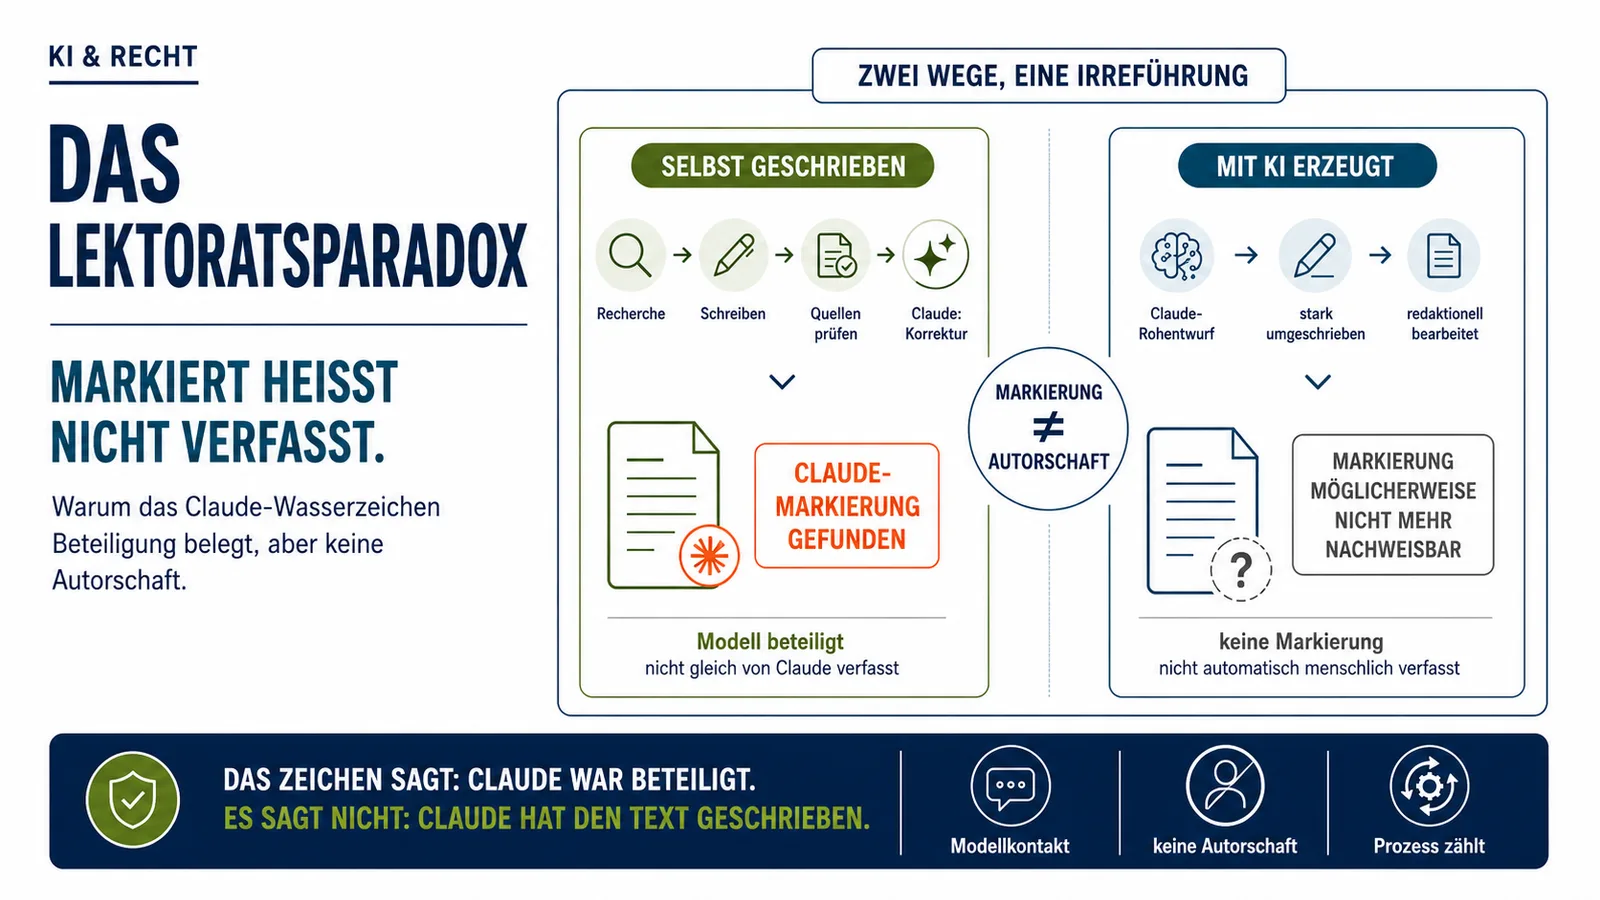
Der Grund ist banal und unangenehm. Wer über einen kleineren Wortschatz verfügt, schreibt vorhersagbarer, und genau darauf reagieren die Dienste. Getroffen wird die einfache Sprache. Es ist dieselbe Mechanik, über die ich im Lektoratsparadox geschrieben habe, jetzt mit Zahlen.
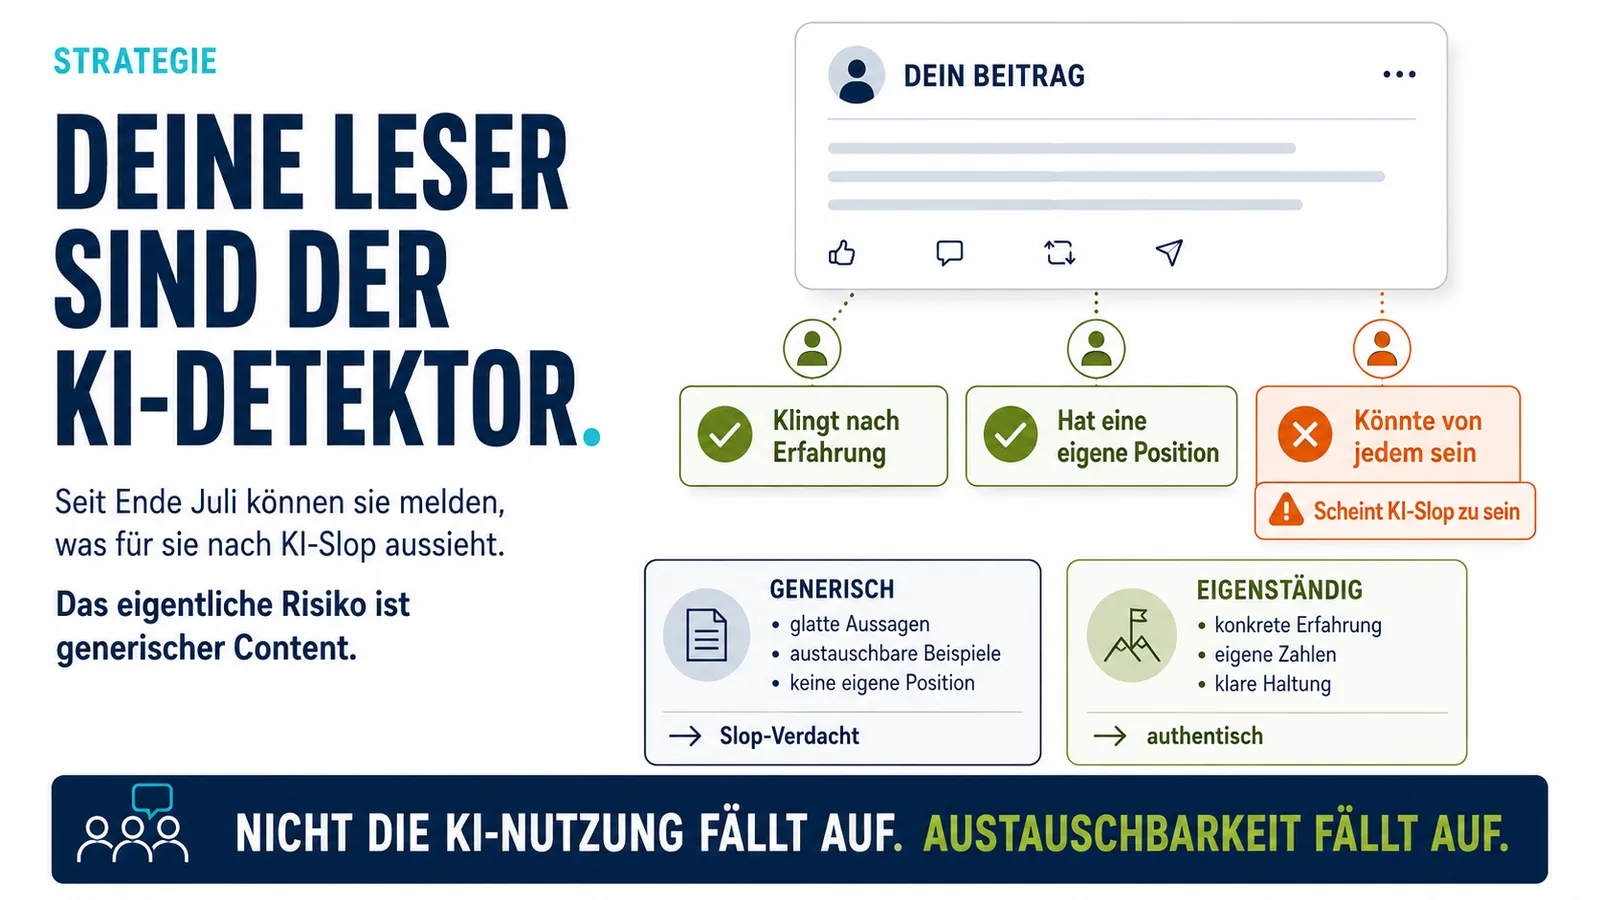
Bei der Sichtbarkeit sieht es ähnlich dünn aus. Google belohnt nach eigener Aussage gute Inhalte, unabhängig davon, wie sie entstanden sind. Belege dafür, dass ein Beitrag allein wegen seines Stils schlechter rankt, gibt es nicht. Was es gibt, sind Leser, die Beiträge als Slop melden können.
Der zweite Rat in derselben Anleitung
Ein paar Abschnitte weiter steht etwas, das mit Stil nichts zu tun hat und mehr über die Richtung verrät als die ganze Wortliste.
OpenAI empfiehlt, dem Modell einen „bias towards action“ mitzugeben. Formulierungen wie „kannst du“ oder „hilf mir“ soll es als Arbeitsauftrag behandeln statt als Einladung zur Rückfrage. Dazu der Satz, an dem ich hängen geblieben bin: Das Modell soll die Freigabe erst einholen, wenn ein fertiges, prüfbares Ergebnis vorliegt. Im Original heißt es „ask for approval only after preparing a concrete, reviewable result“.
Der Rat ist in vielen Fällen vernünftig. Wer bei jeder Kleinigkeit gefragt wird, hört irgendwann auf hinzusehen, und dann ist die Freigabe nur noch ein Klick.
Er verschiebt aber den Moment, in dem ein Mensch eingreift. Vorher war das eine Rückfrage mitten in der Arbeit. Jetzt ist es eine Abnahme am Ende.
Dieselbe Anleitung sagt also zweierlei: Verwisch die Spuren, und hol die Zustimmung später. Beides sind Fragen der Kontrolle, und OpenAI beantwortet beide in dieselbe Richtung.
Wie der Spiegel es gelöst hat
Es gibt eine radikalere Antwort. Ende Juni hat der Spiegel aus seinen internen KI-Richtlinien ein Wort gestrichen. Vorher durften Texte nicht „maßgeblich“ von einer KI geschrieben oder umgeschrieben werden. Jetzt steht dort der Satz von Chefredakteur Dirk Kurbjuweit: „Wir lassen unsere Texte nicht von einer KI schreiben oder umschreiben.“
KI bleibt dort Werkzeug für Recherche und Auswertung, als Autor ist sie raus. Für ein Haus, das seine Glaubwürdigkeit verkauft, ist das nachvollziehbar. Den meisten Content-Teams hilft es nicht weiter.
Was ich in Projekten ändere
Ich übernehme aus OpenAIs Liste, was sich übertragen lässt, und ergänze die fünf deutschen Muster. Die englischen Vokabeln nützen einem deutschen Text wenig, die Konstruktionen dahinter schon.
Wichtiger ist die zweite Änderung. Eine Verbotsliste im Prompt ist eine Anweisung, deren Einhaltung niemand nachprüft. Bei mir läuft deshalb hinter dem Modell ein eigener Schritt, der den fertigen Text gegen die Liste hält.
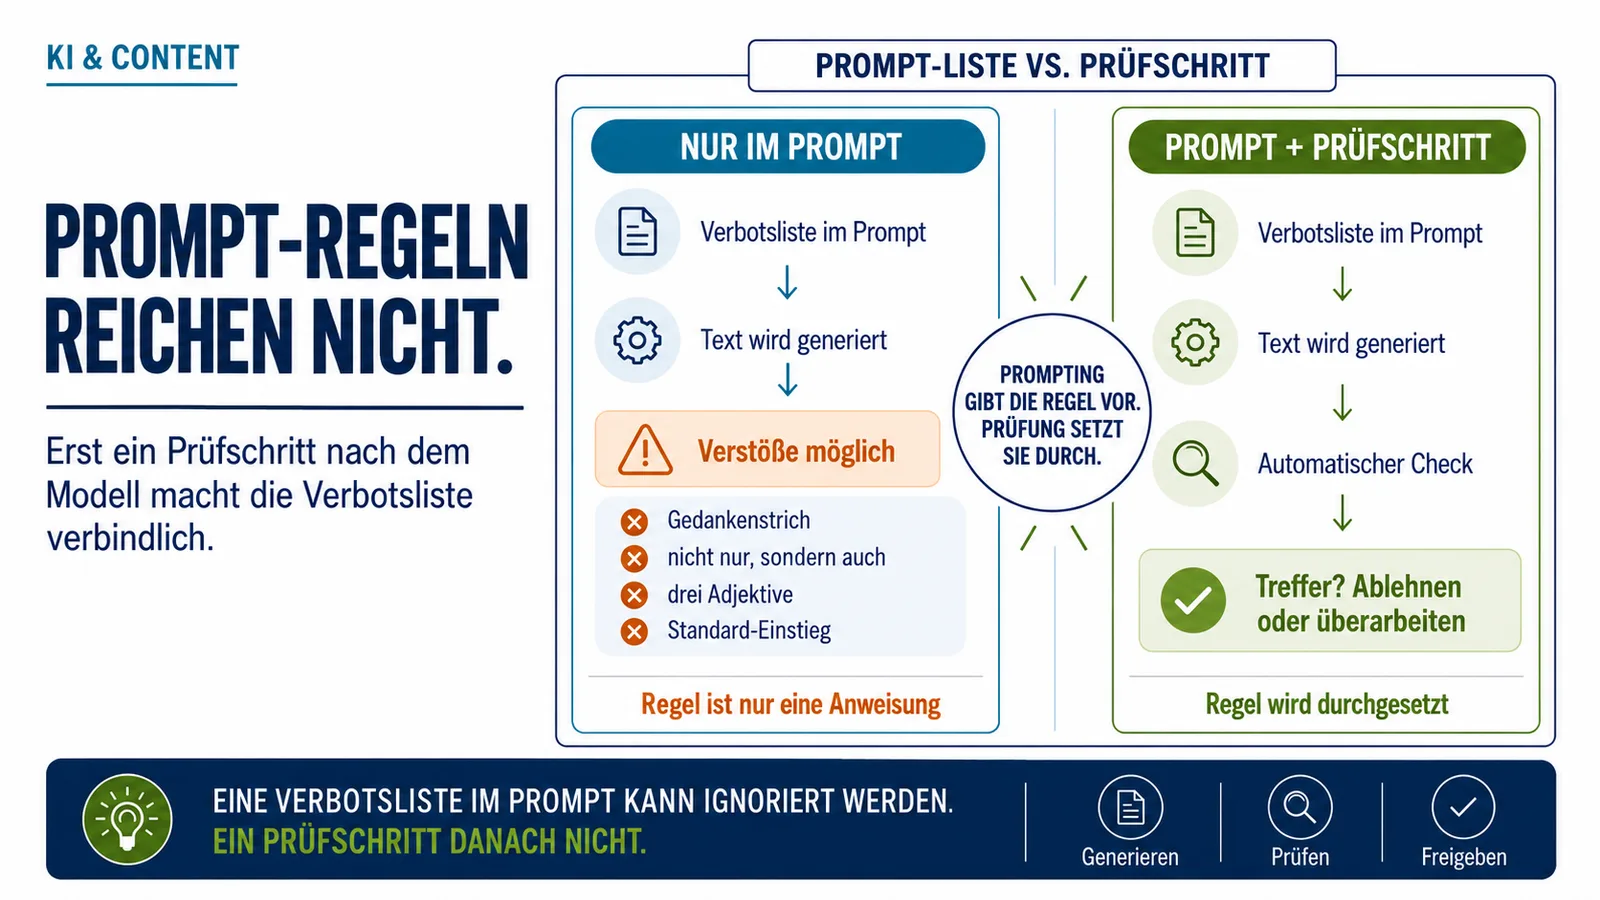
Im KI-News-Scanner, der ohne menschliche Freigabe auf die Website schreibt, lehnt er jede Meldung mit Gedankenstrich ab.
Nötig war das bisher fast nie. Das Modell hält sich an die Regel. Der Unterschied ist, dass ich es weiß, statt es zu hoffen.
Den Freigabepunkt lasse ich, wo er ist. Ein fertiges Ergebnis abzunicken fühlt sich nach Kontrolle an, ist aber die schwächste Form davon. Wer erst am Ende hinsieht, sieht nur noch das Ergebnis.
Womit ich diese Woche anfangen würde
Nimm zehn Texte, die dein Team im letzten Monat mit KI-Hilfe geschrieben hat, und such nach drei Dingen: Gedankenstrich, „nicht nur, sondern auch“, drei Adjektive hintereinander. Das dauert zwanzig Minuten und sagt dir mehr über deinen Ist-Zustand als jede Erkennungssoftware.
Dann entscheide, wo die Liste hingehört. Im Prompt bleibt sie eine Bitte. Verbindlich wird sie erst durch einen Prüfschritt danach.
Gerät in deinem Team jemand unter Verdacht, einen Text von einer KI schreiben lassen zu haben, sind die Zahlen aus Stanford ein gutes Gegenargument. Der Verdacht trifft überdurchschnittlich oft Leute, die einfach schlicht schreiben.