Das Lektoratsparadox: Warum sorgfältige Arbeit als KI markiert wird
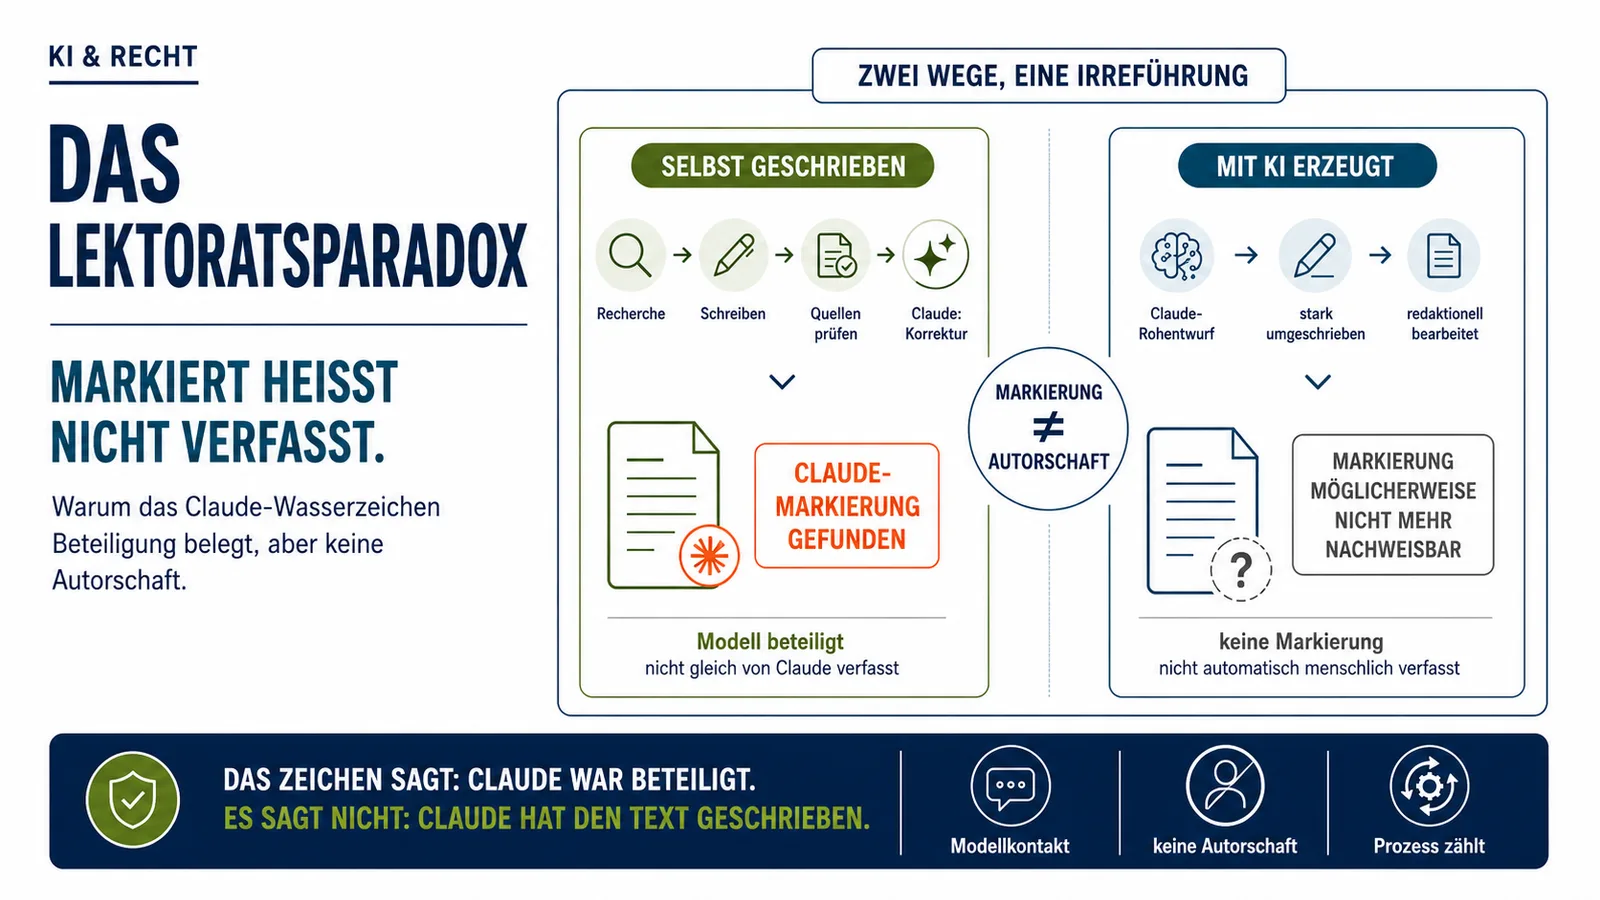
Eine Redakteurin recherchiert drei Stunden, schreibt selbst, prüft zwei Quellen und lässt Claude am Ende die Tippfehler suchen. Der fertige Text kommt markiert zurück. Zwei Türen weiter lässt sich ein Kollege einen Rohentwurf erzeugen und schreibt ihn danach gründlich um. Bei ihm findet sich am Ende möglicherweise gar nichts.
Der Kollege mit der Rechtschreibprüfung
Den ersten Fall beschreibt Anthropic in der eigenen Dokumentation. Claude sei womöglich gar nicht der Urheber, weil Menschen das Modell oft zum Korrekturlesen, Übersetzen, Zusammenfassen oder Umwandeln von Dateien nutzen. Die Ausgabe trage die Markierung trotzdem, auch wenn Idee, Text oder Daten von woanders stammen.
Für den zweiten Fall nennt Anthropic starke Bearbeitung, Umformulierung und Übersetzung als Gründe, warum ein Zeichen fehlen kann. Ob es im Einzelfall wirklich verschwindet, sagt das Unternehmen nicht zu.
Für euch heißt das: Im Zweifel steht die Sorgfältige schlechter da als der Kollege, der wenig selbst formuliert hat.
Was die Markierung misst
Anthropic webt das Wasserzeichen für Menschen unsichtbar in den Text. Bei Dateien kommen signierte Herkunftsdaten nach dem C2PA-Standard dazu. Als Beispiele für unterstützte Dateitypen nennt der Hilfeartikel SVG, PNG und JPG. Zu PDF, Word und PowerPoint schweigt er, weder als zugesagt noch als ausgeschlossen. Wer Pressemappen und Präsentationen ausliefert, sollte das im Blick behalten.
Für die Reichweite gilt eine Einschränkung, die in vielen Meldungen untergeht. Modelle, die ab dem 2. August 2026 erscheinen, können die Kennzeichnung ab Start. Ältere Modelle rüstet Anthropic nach eigener Aussage noch nach und nutzt dafür die Übergangsfrist bis zum 2. Dezember. Welche Modelle heute markieren, veröffentlicht das Unternehmen nicht.
Ein Fund bedeutet deshalb, dass ein Inhalt möglicherweise durch Claude gelaufen ist. Verarbeitet, nicht verfasst.
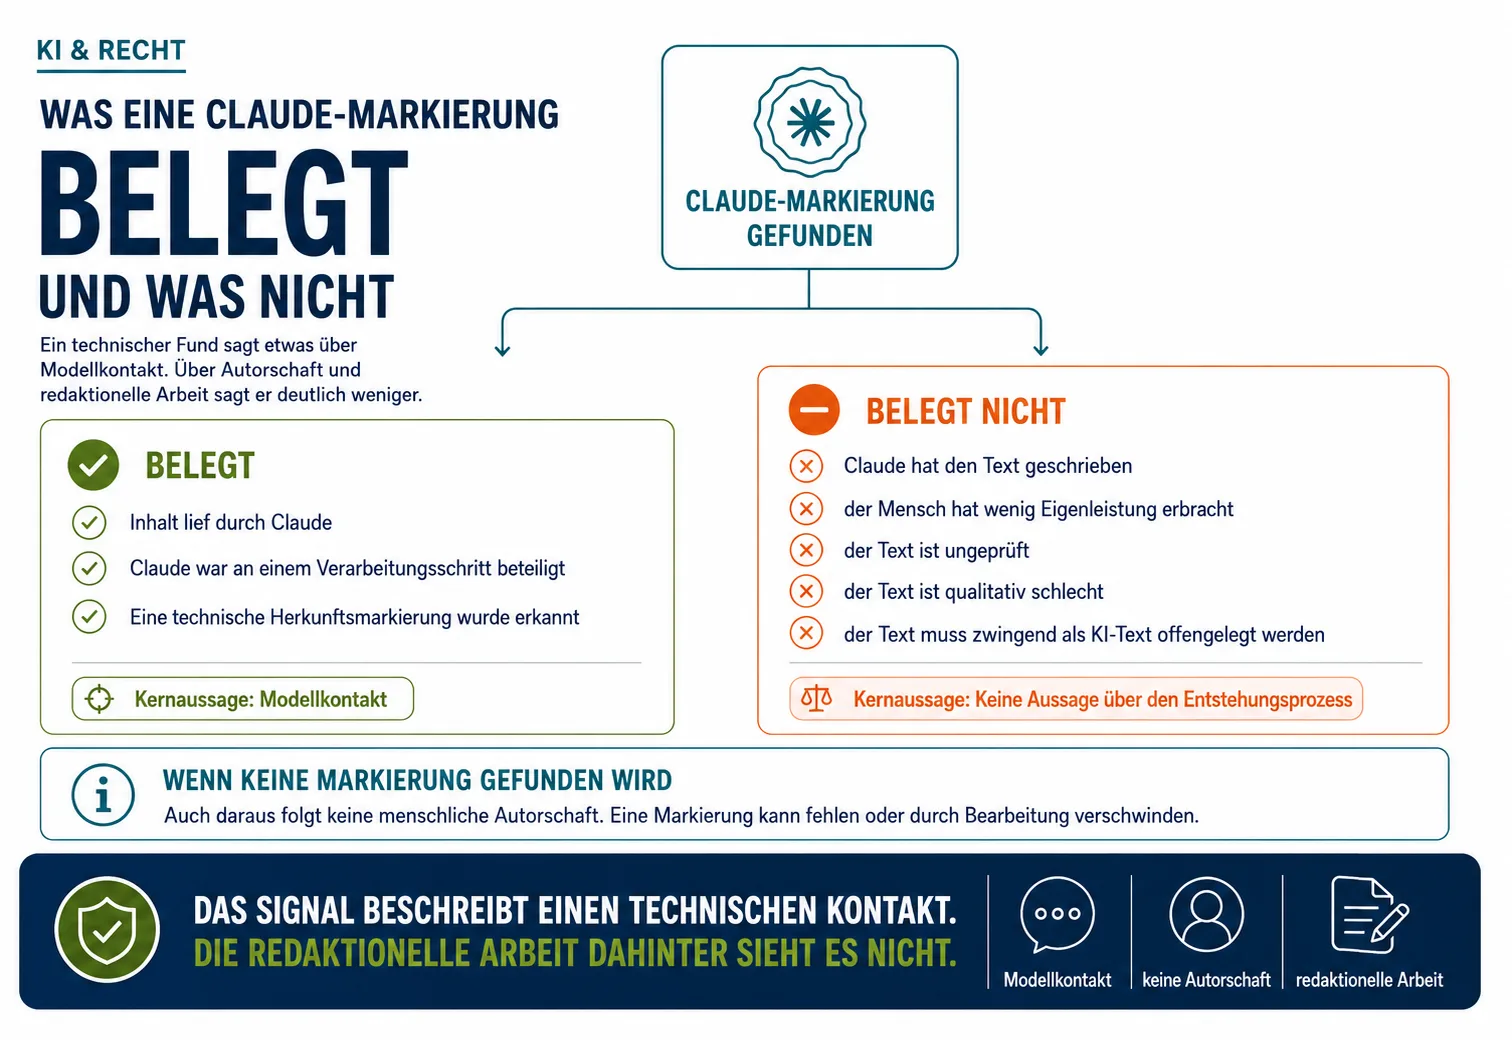
In die Gegenrichtung sagt das Signal noch weniger aus. Eine fehlende Markierung lässt laut Anthropic keinen Schluss auf die Herkunft zu. Nachprüfen könnt ihr ohnehin nichts, denn ein Erkennungswerkzeug hat Anthropic bis heute nicht bereitgestellt und verweist auf technische Dokumentation, die noch aussteht. Der Vorwurf ist ab sofort möglich, die Verteidigung noch nicht.
Zwei Werkzeugklassen, zwei Fehlerarten
An dieser Stelle lohnt eine Unterscheidung, die in der Berichterstattung durcheinandergeht. Es gibt Wasserzeichen, die der Hersteller beim Erzeugen einwebt. Und es gibt statistische Erkenner, die allein aus dem Sprachmuster auf eine Maschine schließen. Beide Klassen versagen, aber in entgegengesetzte Richtungen.
Zu den Wasserzeichen: Ein noch nicht begutachteter Preprint von Tamim und Khan vom 17. Juli 2026 hat drei offengelegte Forschungsverfahren getestet, darunter eine Nachbildung von Googles SynthID. Angegriffen wurde mit Qwen2.5-1.5B, einem frei verfügbaren Modell für gewöhnliche Rechner. Nach einer einzigen Umformulierung war die Markierung bei zweien in allen Fällen verschwunden, bei SynthID in 98,3 Prozent.
Die Zahl daneben sagt mehr über den Alltag aus, denn sie kam ohne jeden Angriff zustande. Vor der Umformulierung übersahen die Verfahren ihre eigene Markierung in 70 bis 83 Prozent der Fälle.
Anthropics Verfahren war nicht Teil dieser Untersuchung und ist bis heute nicht offengelegt. Über dessen Robustheit sagen die Zahlen nichts. Sie beschreiben den Stand der veröffentlichten Verfahren, und der ist dürftig.
Bei den statistischen Erkennern liegt der Fehler auf der anderen Seite. Eine Untersuchung in der Fachzeitschrift Patterns prüfte im März 2023 sieben damals verbreitete Werkzeuge an 91 menschlich verfassten TOEFL-Aufsätzen. Die durchschnittliche Falsch-Positiv-Rate lag bei 61,22 Prozent. Nach einem sprachlichen Aufwertungs-Prompt fielen dieselben Texte auf 11,77 Prozent.
Die Zahlen stammen aus einer einzigen Messung gegen GPT-3.5, und mehrere der getesteten Werkzeuge gibt es nicht mehr. Übertragbar auf heutige Systeme sind sie nicht. Das Muster dahinter bleibt trotzdem lehrreich: Die Werkzeuge bewerten sprachliche Komplexität und schließen daraus auf die Herkunft. Wer in einer Fremdsprache publiziert, hat das Risiko.
Der Unterschied, den keine Erkennung sieht
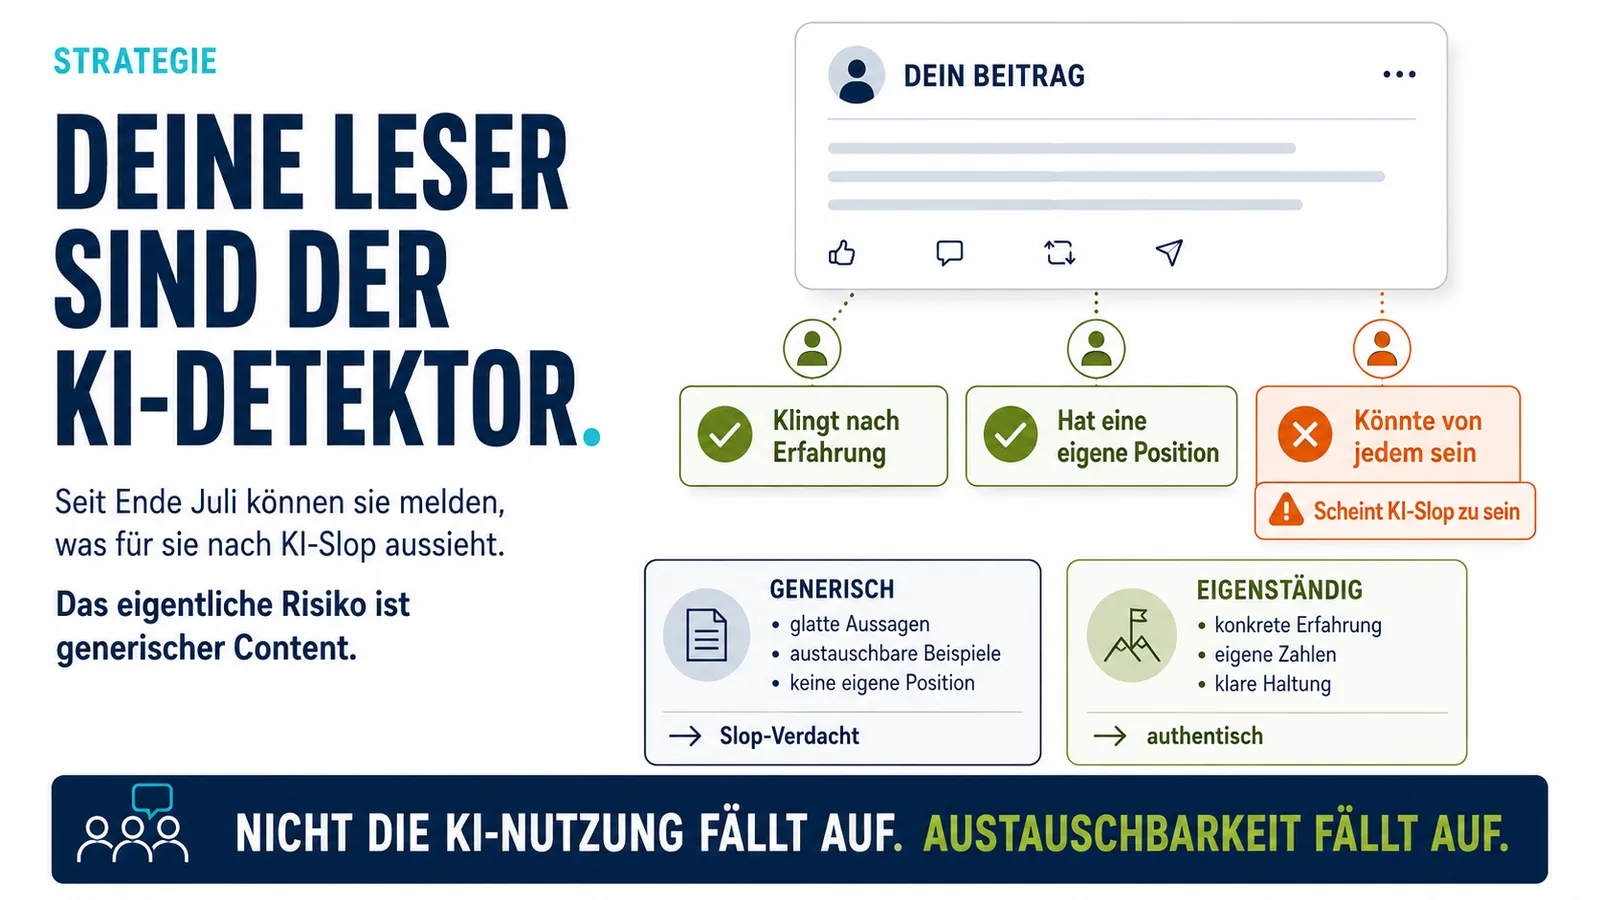
Die Debatte behandelt KI-Text als eine Kategorie. Darin steckt der eigentliche Denkfehler.
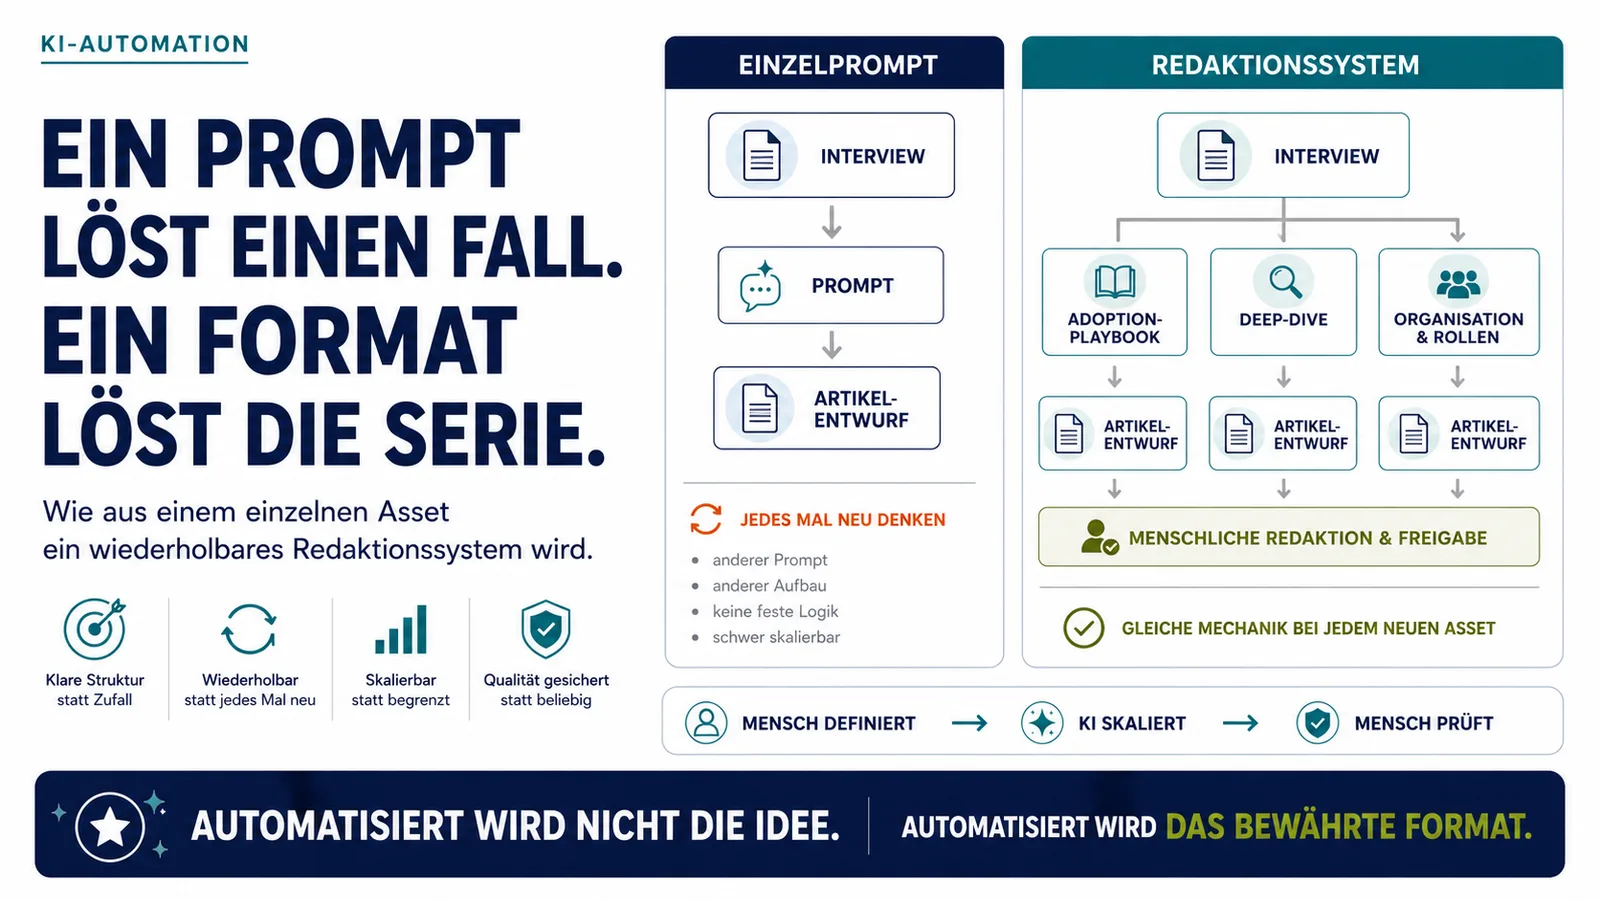
Ein Rohentwurf aus einem Einzelprompt und ein Beitrag aus einem definierten Format sind zwei verschiedene Produkte. Im ersten Fall bekommt das Modell eine vage Aufforderung und liefert den Durchschnitt seiner Trainingsdaten. Im zweiten bekommt es eine Vorgabe, was der Text leisten muss, dazu eine Liste gestrichener Formulierungen. Am Ende korrigiert eine Redaktion.
Beide Ergebnisse bekommen dasselbe Wasserzeichen. Kein Erkennungswerkzeug unterscheidet sie, weil keines die Entstehung sieht, sondern nur die Oberfläche.
So arbeiten meine Redaktionssysteme. Jede Textsorte hat eine Referenz, an der sich der Entwurf ausrichtet, dazu eine Negativliste mit Formulierungen, die nach Maschine klingen und deshalb nicht durchgehen. Aus den Korrekturen der Redaktion zieht das System seine Regeln nach. Am Ende entscheidet ein Mensch.
Das ist der Unterschied zwischen einem Prompt und einem Format. Ein Prompt löst einen Einzelfall, ein Format macht die Serie wiederholbar und prüfbar. Wer wissen will, ob ein Text taugt, muss den Prozess ansehen, denn aus der Datei geht es nicht hervor.
Der Gesetzgeber fragt nach dem Prozess
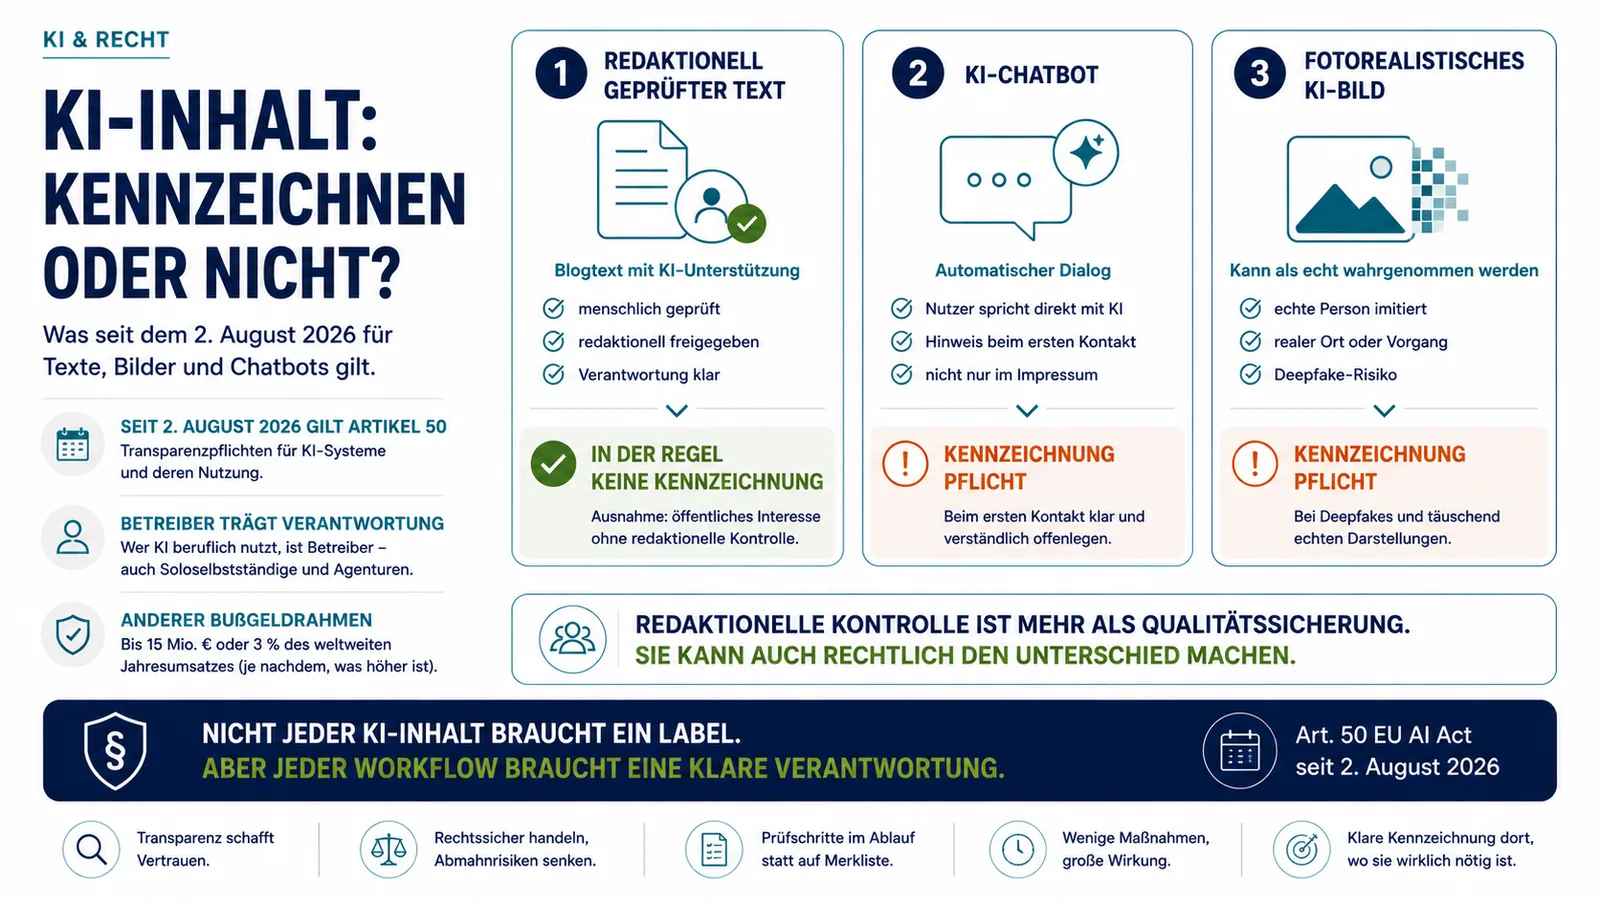
Artikel 50 der KI-Verordnung verteilt die Pflichten auf zwei Adressaten, und die eine erledigt die andere nicht.
Absatz 2 nimmt den Anbieter in die Pflicht, also Anthropic, und verlangt eine maschinenlesbare Markierung. Euch trifft Absatz 4. Der verlangt eine Offenlegung gegenüber Menschen, wenn ihr Text veröffentlicht, um die Öffentlichkeit über Angelegenheiten von öffentlichem Interesse zu informieren. Ein unsichtbares Zeichen erfüllt das nicht, weil es niemand wahrnimmt. Für Bild, Ton und Video hat die Kommission das im Fragenkatalog vom 24. Juli 2026 ausdrücklich festgehalten: Betreiber können sich nicht einfach auf die maschinenlesbare Markierung verlassen, die der Anbieter nach Absatz 2 eingebettet hat. Zum Textfall äußert sie sich dort nicht, die Systematik der Norm ist aber dieselbe.
Den Bußgeldrahmen für Verstöße gegen Artikel 50 setzt Artikel 99 Absatz 4. Er reicht bis zu 15 Millionen Euro oder bis zu drei Prozent des weltweiten Jahresumsatzes. Bei Unternehmen gilt der höhere Betrag. Für kleine und mittlere Unternehmen greift Absatz 6 mit dem jeweils niedrigeren Wert. Die vielzitierten 35 Millionen stehen in Absatz 3 und betreffen ausschließlich die verbotenen Praktiken nach Artikel 5.
Jetzt die Entlastung, und sie steht im selben Absatz wie die Pflicht. Ausgenommen sind Texte, die eine menschliche Überprüfung oder redaktionelle Kontrolle durchlaufen haben, sofern eine natürliche oder juristische Person die redaktionelle Verantwortung für die Veröffentlichung übernimmt. Der Bundesverband Digitalpublisher und Zeitungsverleger legt das in seiner Branchennachricht vom 4. August 2026 genauso aus: Redaktionell geprüfte und verantwortete Texte müssen in der Regel nicht als KI-Inhalte ausgewiesen werden.
Ausschlaggebend ist damit, ob ein Mensch geprüft hat und ob dieser Mensch benennbar ist. Wer freigibt, hat das bisher aus Gründen der Qualität festgehalten. Seit August trägt derselbe Eintrag den Nachweis, dass ihr den Hinweis in der Regel weglassen dürft.
Wie die Aufsicht das im Einzelfall sieht, weiß bislang niemand. Bis Redaktionsschluss ist mir keine Abmahnung wegen fehlender KI-Kennzeichnung bekannt geworden. Die Wettbewerbszentrale hat am 28. Juli ein Beschwerdeformular eingerichtet, die Bundesnetzagentur nimmt seit dem 29. Juli Beschwerden entgegen. Das hier bleibt meine Einordnung als Praktiker und ersetzt keine Rechtsberatung.
Für Google ändert sich nichts
Beim Thema Sichtbarkeit habe ich mit einer anderen Antwort gerechnet und mich geirrt.
In keiner öffentlichen Google-Dokumentation taucht ein Zusammenhang zwischen Wasserzeichen und Ranking auf. Die Herkunftsprüfung, die Google im Mai vorgestellt hat, richtet sich an Nutzer und deckt Bildmaterial ab. Text gehört bislang nicht dazu. In der Dokumentation für Website-Betreiber kommen Wasserzeichen, SynthID und C2PA an keiner Stelle vor.
Die Spam-Richtlinie zielt auf Masse ohne Mehrwert und stellt ausdrücklich klar, dass die Erzeugungsart keine Rolle spielt. Zu den Bewertungsrichtlinien für Qualitätsprüfer schreibt Google, deren Bewertungen wirkten nur mittelbar auf das Ranking. Verbindlich wird die Kennzeichnung dort, wo Google eigene Plattformen kontrolliert. Im Merchant Center müssen Händler seit Februar 2024 die IPTC-Metadaten von KI-Bildern erhalten. Auf YouTube gilt seit März 2024 eine Offenlegungspflicht für realistisch wirkende synthetische Inhalte.
Bei KI-Antwortsystemen ist die Lage ähnlich. Ich habe die öffentlichen Dokumente von OpenAI, Perplexity, Microsoft und Google durchgesehen und keine Aussage dazu gefunden, ob Herkunftsdaten in die Auswahl zitierter Quellen einfließen.
Meine Vermutung war, der Hebel liege bei den Trainingsdaten. Wenn markierter Text erkennbar wird, könnten Labore ihn aus ihren Datensätzen filtern. Wer nicht im Modell landet, taucht in Antworten seltener auf. Diese Vermutung hält der Prüfung nicht stand. In den technischen Berichten zu FineWeb, Dolma, RedPajama und Llama 3 findet sich kein Filter auf maschinengenerierte Inhalte. Modellbasierte Qualitätsfilter gibt es dort sehr wohl, die bewerten aber etwas anderes. NVIDIAs Nemotron-CC geht den umgekehrten Weg und mischt 1,9 Billionen synthetisch erzeugte Wortbausteine bewusst hinzu.
Drei Änderungen in laufenden Projekten
Der Freigabeschritt landet jetzt im Protokoll: wer geprüft hat, wann, und wer die Verantwortung für die Veröffentlichung übernimmt. Bisher stand das in Trello oder im Google Doc und diente der Qualitätssicherung. Kommt der Vorwurf, ein Text stamme aus der Maschine, hilft die Datei nicht weiter, denn ein Fund beweist keine Autorschaft und ein fehlender Fund keine Handarbeit. Dann zählt nur, was außerhalb der Datei steht.
Bei Vertragsklauseln zur KI-Freiheit widerspreche ich inzwischen. Manche Formulierungen sichern dem Kunden zu, dass gelieferte Texte keine KI-Markierung enthalten. Damit verbieten sie faktisch die Rechtschreibprüfung, und einhalten lässt sich das nicht. Eine Zusage über die dokumentierte redaktionelle Prüfung funktioniert dagegen.
Für Bilder führe ich den Herkunftsnachweis getrennt. C2PA-Daten überstehen die Verarbeitung im Netz schlecht. WordPress entfernt beim Erzeugen von Bildgrößen standardmäßig Metadaten. Cloudflare Images verwirft Content Credentials, solange die Einstellung „Preserve Content Credentials“ nicht aktiviert ist. Wer die Herkunft eines Titelbilds nachweisen will, dokumentiert sie im Redaktionssystem.
Eine Zahl fehlt in alledem, und ich will sie am dringendsten sehen: Zu seinem eigenen Verfahren hat Anthropic bis heute keine Fehlerrate veröffentlicht. Solange die aussteht, weiß niemand, wie oft die Markierung die Falschen trifft. Wie teuer nachträgliche Prüfarbeit wird, habe ich in der Verifizierungssteuer durchgerechnet.