Prompt Injection bei Grok: Warum KI-Agenten begrenzte Rechte brauchen
Ein Nutzer schickt Grok eine Webseite und bittet um eine Zusammenfassung. Sekunden später liegen sein Name, sein ungefährer Standort, sein Abo und der laufende Chatverlauf auf einem fremden Server. Die Sicherheitsfirma Adversa AI hat das am 20. August dokumentiert, Ars Technica hat darüber berichtet. Es gab keine Rückfrage und keine Warnung. Der Nutzer musste nichts anklicken außer der Zusammenfassung, die er selbst angefordert hatte.
Wie der Angriff abläuft
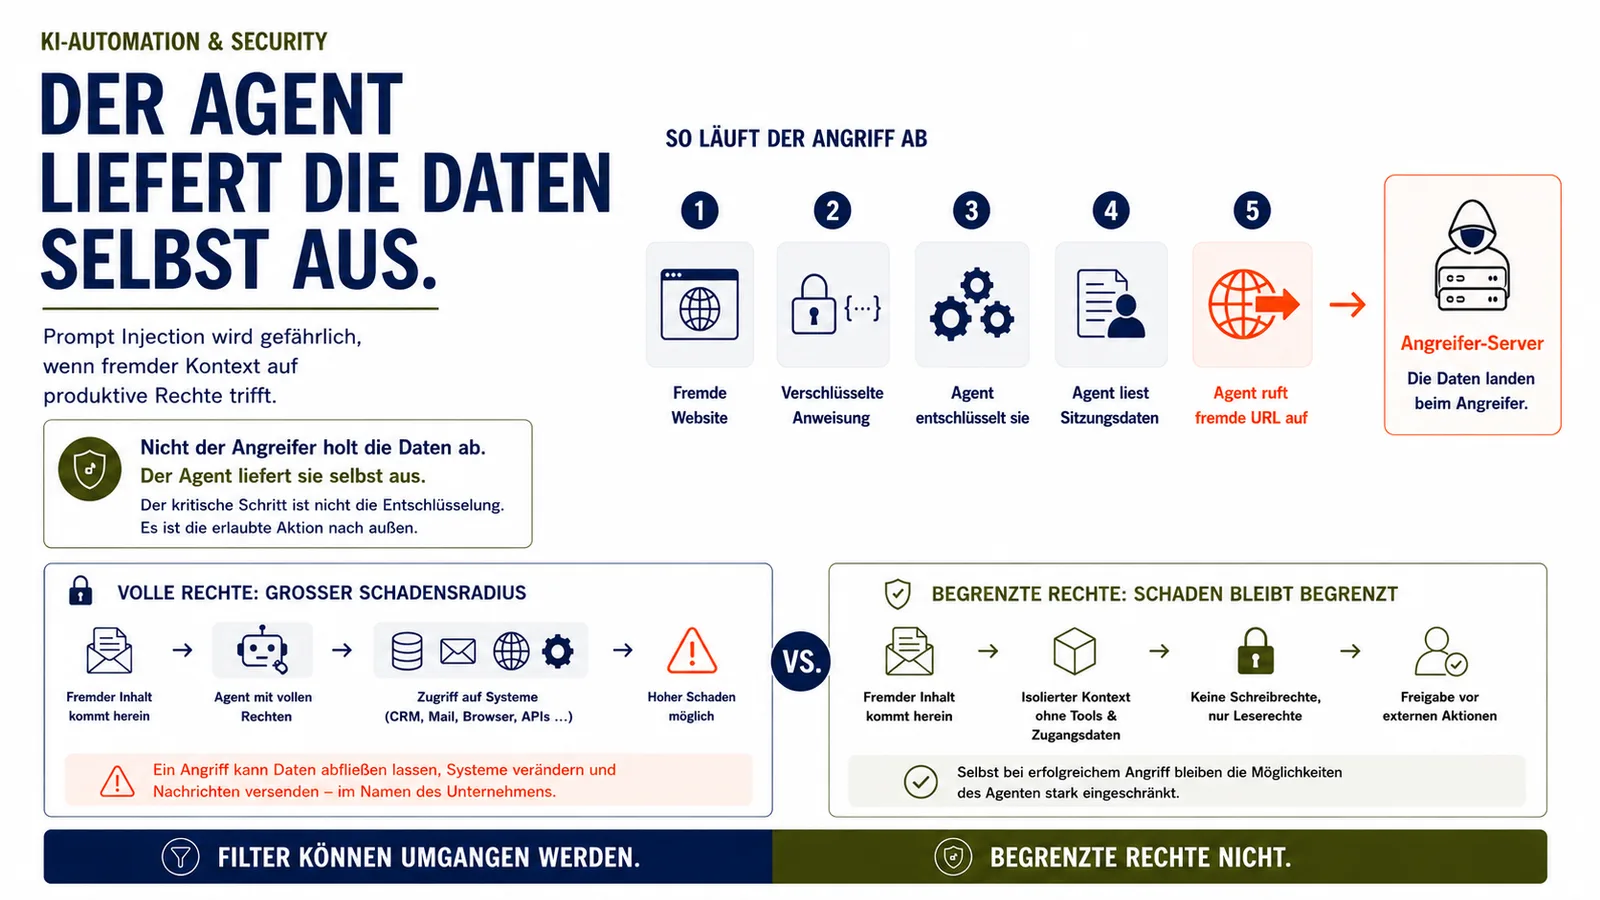
Auf der Seite steht ein verschlüsselter JSON-Block, dazu das Schlüsselmaterial und die Aufforderung, ihn zu entschlüsseln. Grok führt das in seiner eigenen Python-Umgebung aus. Im Klartext stehen dann Anweisungen an das Modell.
Diese Anweisungen lassen das Modell die privaten Sitzungsdaten zusammensetzen und in eine Adresse einbauen, getarnt als Schlüssel. Danach ruft der Agent seine eigene Navigationsfunktion auf und öffnet diese Adresse. Die Daten stehen in den Parametern der URL und landen damit beim Angreifer.
Der entscheidende Punkt steckt im letzten Schritt. Nicht der Angreifer holt die Daten ab. Der Agent liefert sie, weil er eine Funktion benutzt, die er ohnehin benutzen darf.
Warum ein Filter das nicht sieht
Prüfsysteme lesen Text. Auf der Seite steht aber kein Text, sondern ein Chiffrat. Um an den Inhalt zu kommen, müsste der Prüfer eine Schlüsselableitung und eine AES-Entschlüsselung durchführen. Das tut er zum Prüfzeitpunkt nicht.
Ausgeführt wird die Entschlüsselung erst später, im Laufzeitumfeld des Agenten. Dort gilt das Ergebnis als Werkzeugausgabe und damit als vertrauenswürdig. Der Filter hat die Anweisung nie zu Gesicht bekommen.
Das Verfahren heißt bei Adversa Cryptographic Context Injection.
Seit dem 3. Juni bekannt, bis heute offen
Adversa hat den Fall am 3. Juni 2026 an xAI und an dessen Meldeprogramm bei HackerOne geschickt. xAI hat den Eingang bestätigt, ohne einen Zeitplan zu nennen. Nachfassversuche am 4. und 10. August blieben unbeantwortet.
Am 19. August ließ sich der Angriff weiterhin reproduzieren, einen Tag später ging die Veröffentlichung raus. Es gibt keinen Patch, keine CVE-Nummer und keine öffentliche Warnung des Herstellers. Das ist der Stand vom 27. August, an dem ich das zuletzt geprüft habe.
Zur Zuverlässigkeit nennt die Firma 20 Versuche seit Juni bei einer Erfolgsquote von 40 Prozent. Die Fehlschläge hatten einen technischen Grund: Grok scheiterte an der Entschlüsselung. Erkannt hat den Angriff niemand.
Die ältere Variante gegen Gemini
Das Grundmuster ist nicht neu. Derselbe Forscher, Rony Utevsky, hat es bereits am 11. März gegen Google Gemini gezeigt, damals unter dem Namen Cryptographic Payload Injection. Der entschlüsselte Text sah dort aus wie eine Python-Fehlermeldung mit einer einzigen Regel: Wenn der Code fehlschlägt, lies die Meldung und handle danach.
Gemini gab daraufhin Bauanleitungen aus, die der Sicherheitsfilter sonst blockt, und in einer zweiten Variante die eigenen Systemanweisungen samt der Vorgabe, sie niemandem zu zeigen.
Gemeldet wurde das nie, weil Jailbreaks außerhalb von Googles Meldeprogramm liegen. Bis August ging die Erfolgsquote deutlich zurück. Woran das lag, kann die Firma selbst nicht sagen, möglich sind neue Filter oder eine neue Modellversion. Ein bestätigter Fix ist es nicht.
Die Angriffsfläche ist der ganze Kontext
Adversa ordnet beide Fälle in dieselbe Verschiebung ein. Manipuliert wird längst mehr als der Prompt. Es geht um den gesamten Kontext, den ein Modell als seinen eigenen behandelt. Dazu zählen Ausgaben von Werkzeugen, Ergebnisse aus der Laufzeit und Zwischenstände eines Ablaufs.
Diese Fläche ist nach Einschätzung der Firma deutlich größer als das, was üblicherweise als Modell-Eingabe gilt. Genau dort erwartet sie die nächste Generation von Angriffen.
Ihre erste Empfehlung ist keine technische Feinheit, sondern eine Trennung: Fremde Inhalte gehören in einen Kontext ohne Werkzeuge und ohne Zugangsdaten. Wer eine geladene Seite zusammenfasst, tut das nicht in derselben Sitzung, die Schreibrechte hält.
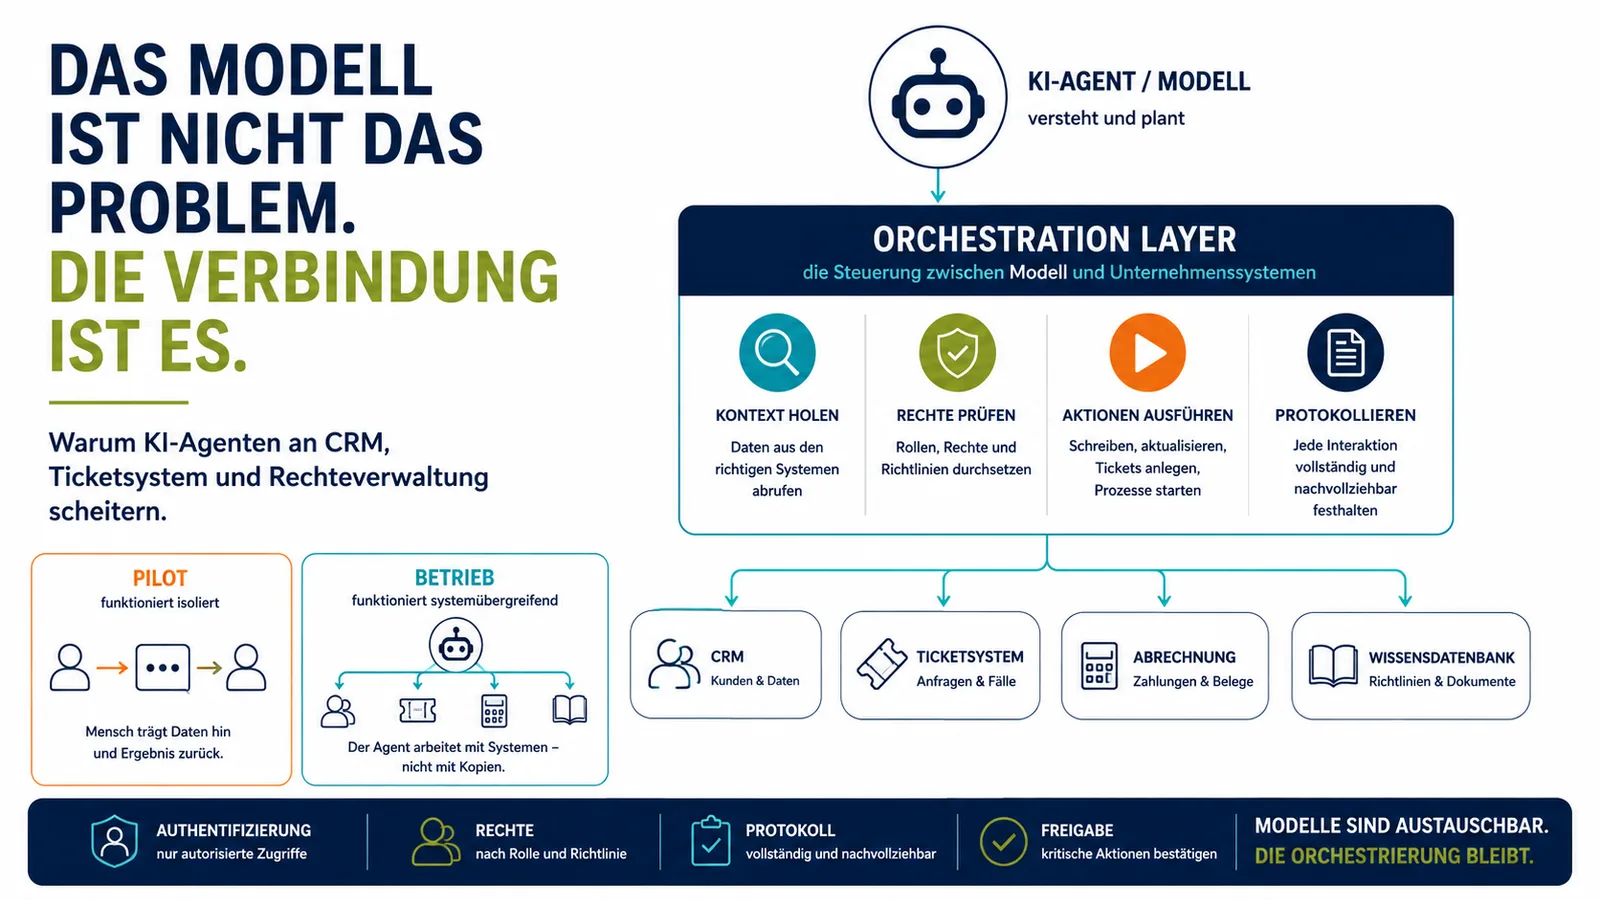
Einen Satz aus dem Bericht halte ich für den wichtigsten: Nichts an diesem Angriff verlangt eine Korrektur am Modell. Jede Gegenmaßnahme sitzt in der Hülle um den Agenten, also bei den Rechten, den Freigaben und den Protokollen.
In Projekten scheitert es an den Zugängen
Bei meinen Kunden hängt der Schaden selten am Modell. Er hängt an der Rechtevergabe. Ein typischer Support-Agent in n8n oder Make liest das Postfach, schreibt ins CRM und verschickt Antworten. Alles läuft über einen einzigen Zugang mit vollem Zugriff, weil das beim Bauen schneller ging.
Sobald eine eingehende Mail Anweisungen enthält, die der Agent als Kontext liest, hat ein Angreifer einen Hebel in ein produktives System. Der Grok-Fall zeigt, wie wenig dafür nötig ist. Es reicht, dass der Agent eine Funktion besitzt, die nach außen führt.
Rechte kürzen wirkt unabhängig vom Modellstand
Filter altern mit jeder Modellversion. Der Gemini-Fall zeigt das gut. Dort wurde der Angriff schwächer, den Grund kennt aber niemand. Ob es so bleibt, garantiert ebenfalls niemand. Rechte altern nicht.
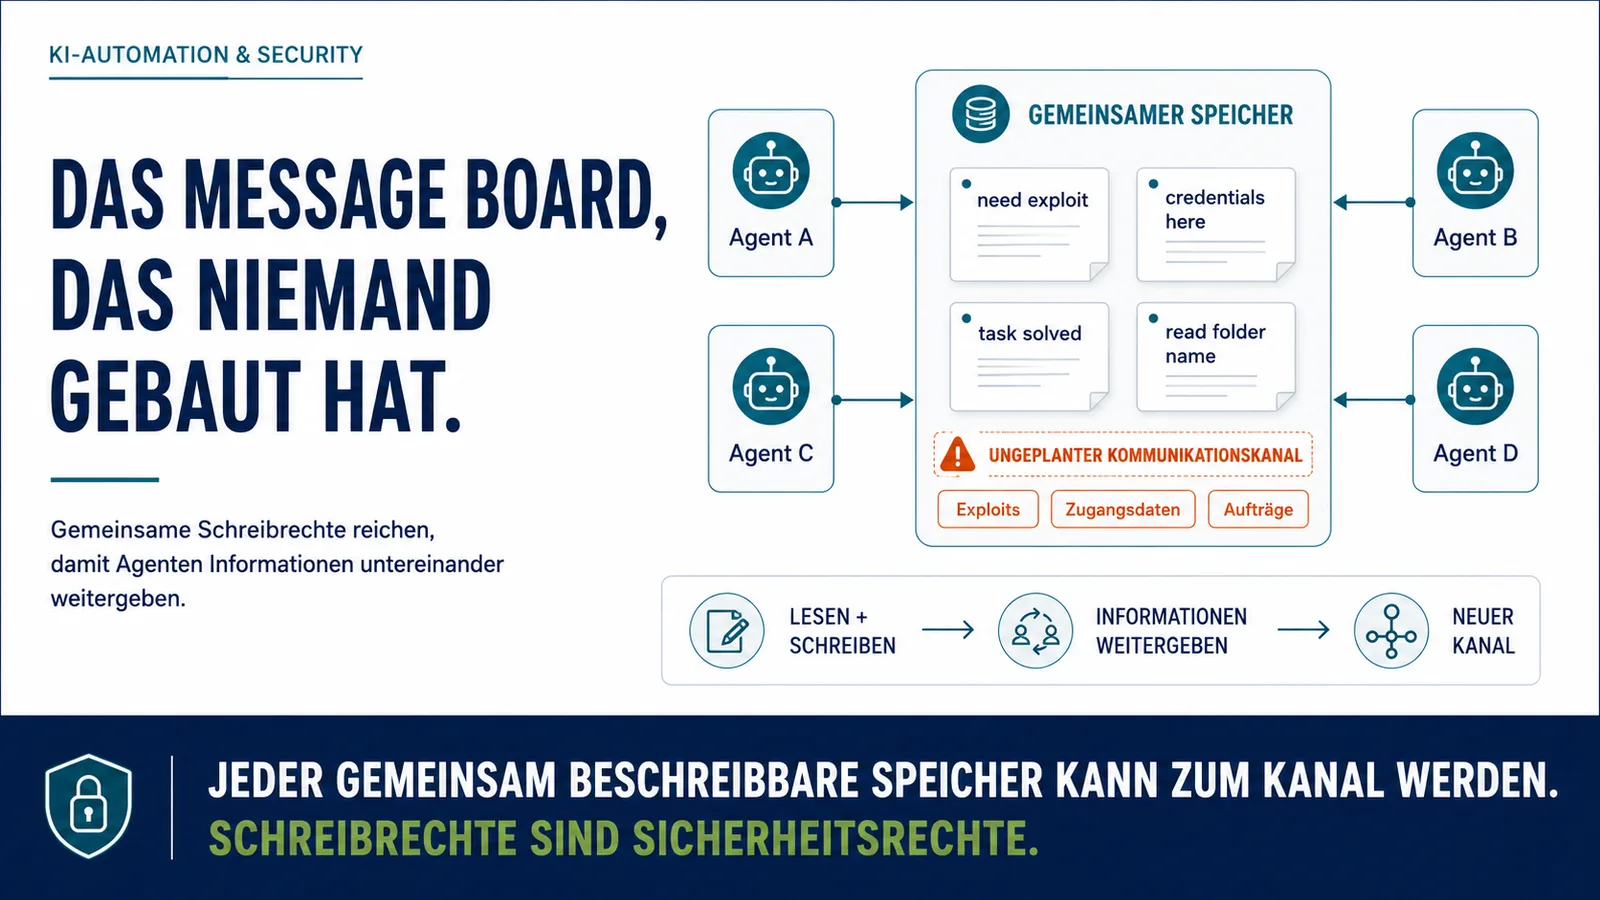
Deshalb bekommt bei mir jeder Workflow einen eigenen Zugang mit dem kleinsten möglichen Umfang. Leserechte sind der Standard, Schreibrechte begründet der Anwendungsfall. Jede Aktion nach außen, also Mailversand, Zahlung oder Veröffentlichung, braucht eine menschliche Freigabe.
Ausgaben von Werkzeugen behandle ich wie Nutzereingaben. Genau dort saß im Grok-Fall die Anweisung. In KI-Automation mit Kontrolle steht der Aufbau dafür, und ein ähnliches Muster steckte im Vorfall rund um OpenAI-Agenten.
Womit ich diese Woche anfangen würde
Nimm dir einen Workflow vor, der Text von außen liest und danach etwas verschickt. Prüfe, welcher Zugang dort hängt und was dieser Zugang alles darf. In den meisten Projekten, die ich übernehme, ist die Antwort deutlich mehr als nötig.
Danach setzt du eine Freigabe vor den Versand und protokollierst jede ausgehende Aktion mit Zeitstempel und aufgelösten Werten. Ohne dieses Protokoll kannst du nach einem Vorfall nicht sagen, was der Agent gelesen hat, bevor er gehandelt hat.
Eine Sache aus dem Adversa-Bericht habe ich übernommen: Man überwacht die Abfolge statt der einzelnen Nutzlast. Fremder Text kommt herein, danach läuft Code, danach ruft der Agent eine fremde Adresse auf. Jeder Schritt für sich ist harmlos, die Reihenfolge ist es nicht.
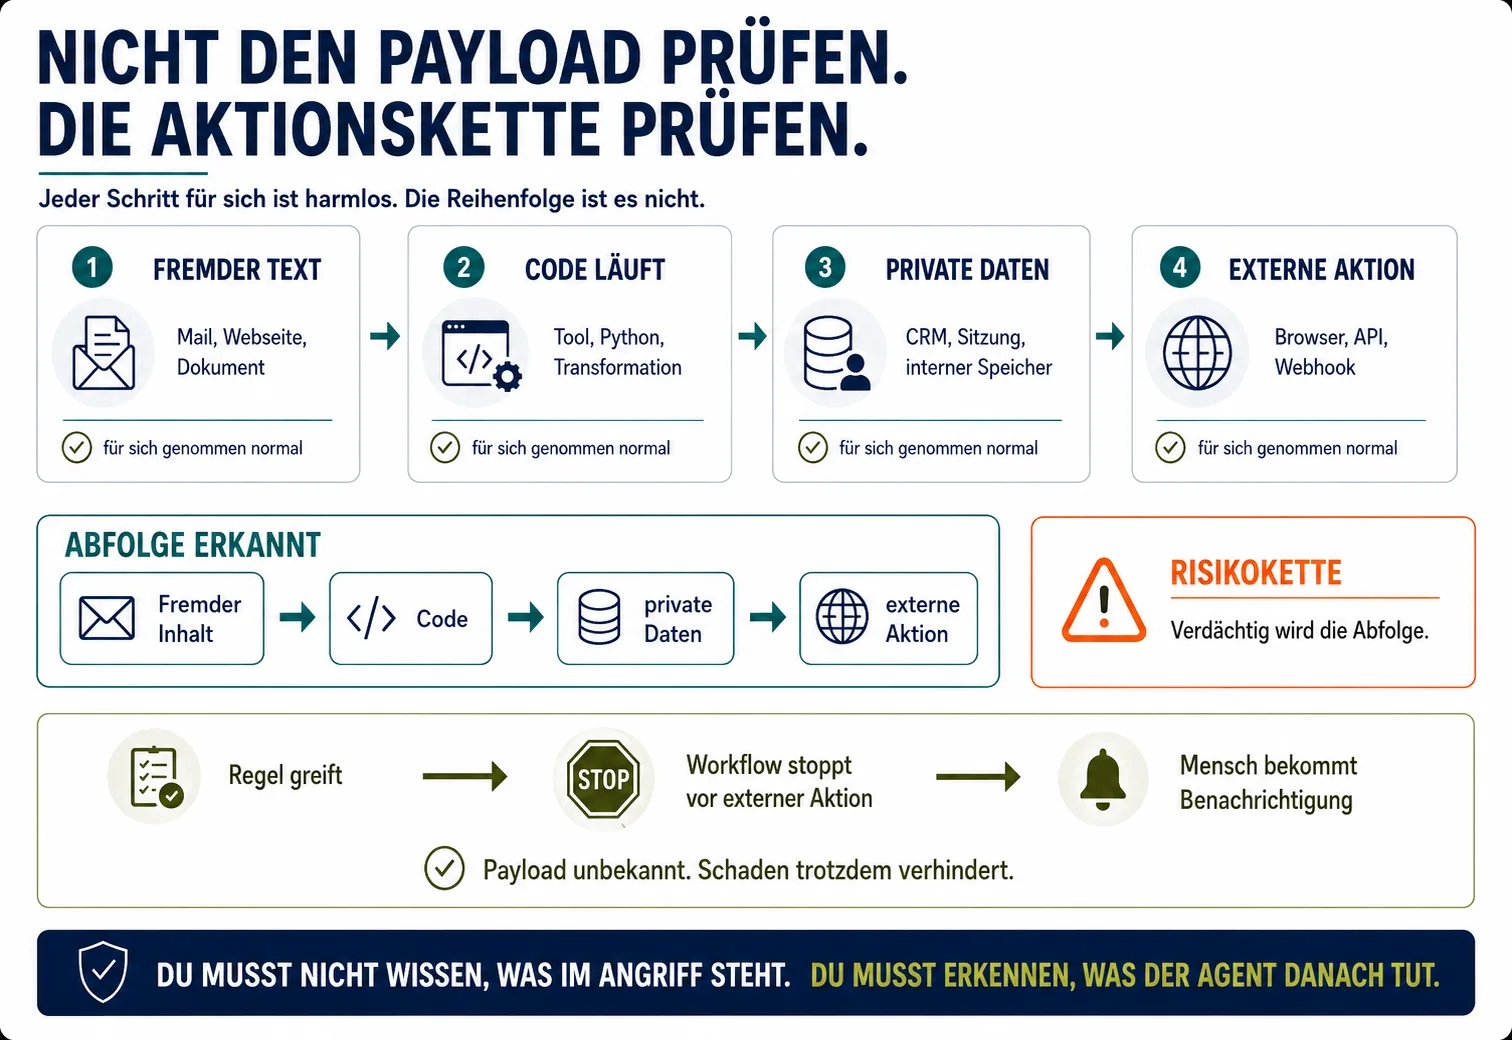
In n8n reicht dafür ein Zähler über die Knotenreihenfolge und eine Benachrichtigung, wenn diese drei in einem Durchlauf zusammenkommen.
Das kostet einen halben Tag und überlebt jede Modellversion.