Claude Fable 5.1 ist da: 75 Prozent günstiger, zwei Prozent auf der Rechnung
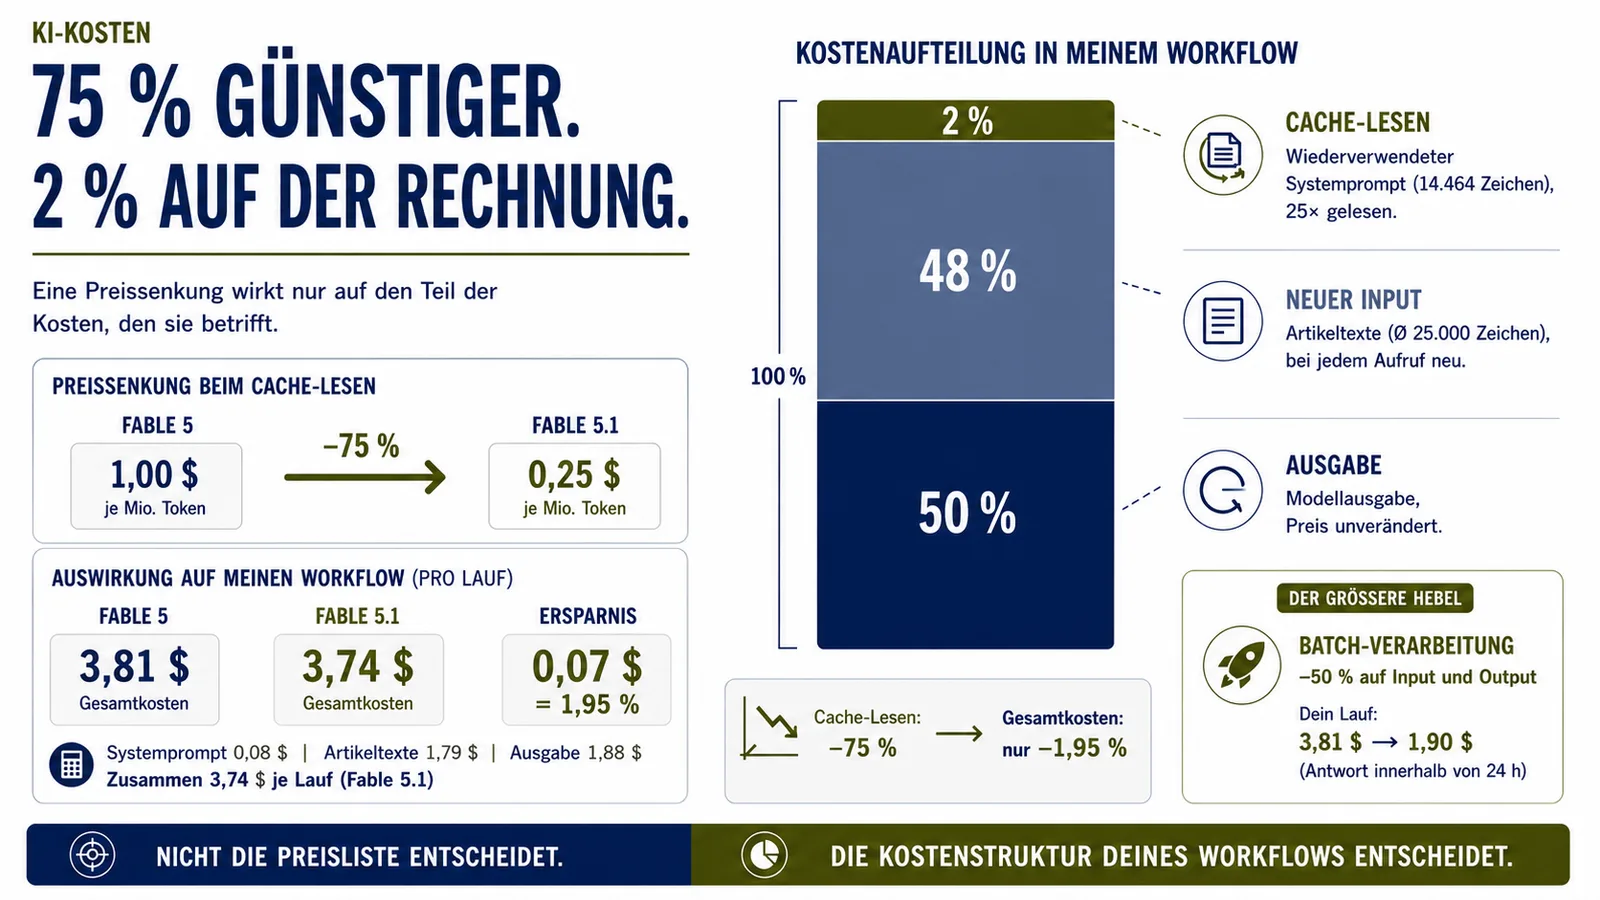
Anthropic hat am 1. September Claude Fable 5.1 veröffentlicht und dabei den Preis für Cache-Lesen von einem Dollar auf 25 Cent je Million Token gesenkt. Minus 75 Prozent. Das Unternehmen nennt dazu rund 25 Prozent weniger Kosten bei typischen Aufgaben und bis zu 45 Prozent bei stark agentischen Abläufen. Ich habe es an meinem eigenen Workflow nachgerechnet. Dort sind es zwei Prozent.
Worum es überhaupt geht
Kurz für alle, die nicht täglich mit Schnittstellen arbeiten. Jede Anfrage an ein Sprachmodell besteht aus zwei Teilen. Einem festen Teil, der bei jedem Aufruf gleich bleibt, also der Anweisung, wie das Modell arbeiten soll. Und einem wechselnden Teil, dem eigentlichen Inhalt. Abgerechnet wird nach Token, also nach Textbausteinen von grob drei bis vier Zeichen.
Caching heißt: Der feste Teil wird einmal hinterlegt und bei den folgenden Aufrufen nur noch gelesen statt jedes Mal neu verarbeitet. Lesen ist deutlich billiger als verarbeiten. Genau dieses Lesen hat Anthropic jetzt noch einmal billiger gemacht.
Ein Blick in die Preistabelle klärt den Rest schneller als jede Meldung. Eingabe kostet weiterhin 10 Dollar je Million Token, Ausgabe weiterhin 50. Das Hinterlegen im Cache kostet ebenfalls unverändert, nämlich 12,50 Dollar für fünf Minuten Haltbarkeit und 20 Dollar für eine Stunde. Gesenkt wurde eine einzige Position: das Lesen aus dem Cache.
Daraus folgt eine simple Rechnung. Wenn nur eine Position um 75 Prozent sinkt, fällt die Gesamtrechnung nur dann um 25 Prozent, wenn diese Position vorher ein Drittel der Kosten ausmachte. Für die genannten 45 Prozent müssten es vorher 60 Prozent gewesen sein.
Das sind keine unrealistischen Anteile. Ein Programmier-Agent, der zwanzig Mal dieselbe Codebasis durchgeht, liegt dort leicht. Die Frage ist nur, ob der eigene Ablauf so aussieht.
Nachgerechnet an meinem Themenscanner
Mein Workflow für die Themenrecherche schickt pro Lauf 25 einzelne Anfragen an das Modell. Jede enthält denselben Systemprompt mit 14.464 Zeichen und jeweils einen anderen Artikeltext. Ein Fall, wie ihn viele Content-Workflows haben.
So sieht die Rechnung aus, gerechnet mit funktionierendem Caching und 3,5 Zeichen je Token:
Systemprompt, 25 Mal wiederverwendet: 0,08 Dollar. Artikeltexte: 1,79 Dollar. Ausgabe: 1,88 Dollar. Zusammen 3,74 Dollar je Lauf.
Der gecachte Teil macht damit 2 Prozent der Rechnung aus. Die Artikeltexte 48 Prozent, die Ausgabe 50 Prozent. Gegenüber Fable 5 spare ich 7 Cent je Lauf, also 1,95 Prozent.
Ich habe die Rechnung mit drei, dreieinhalb und vier Zeichen je Token durchgespielt. Das Ergebnis liegt immer zwischen 1,8 und 2,1 Prozent. An der Größenordnung ändert die Schätzung nichts.
Warum so wenig ankommt
Der Grund steckt in der Struktur, nicht im Preis. Cache-Lesen betrifft nur den Teil des Prompts, der sich wiederholt. Bei mir ist das der Systemprompt, und der ist klein gegenüber dem, was jedes Mal neu dazukommt.
Ein Artikel mit 25.000 Zeichen ist fast doppelt so lang wie mein gesamter Systemprompt, und er ist bei jedem der 25 Aufrufe ein anderer. Für ihn zahle ich vollen Eingabepreis, vorher wie nachher. Die Ausgabe kostet ebenfalls unverändert 50 Dollar je Million Token, und sie ist bei mir der größte Einzelposten.
Anthropics 25 Prozent sind nicht falsch. Sie stammen aus vier Wochen echter Nutzung über Claude Code, Claude Enterprise und die Programmierschnittstelle. In diesem Mix haben Cache-Lesevorgänge einen viel größeren Anteil als in einem Ablauf, der 25 fremde Dokumente durchgeht.
Der Haken, den es in n8n gar nicht gibt
Beim Nachrechnen ist mir etwas aufgefallen, das die zwei Prozent noch einmal relativiert. In meinem Workflow läuft überhaupt kein Caching. Nicht weil ich es vergessen hätte, sondern weil es die Einstellung nicht gibt.
Ich habe mir die Knotendefinitionen aus meiner n8n-Instanz ausgeben lassen. Der Anthropic-Knoten kennt Optionen für Modell, maximale Token, Temperatur, Websuche und Werkzeugdurchläufe. Prompt-Caching ist nicht dabei. Beim Anthropic-Chat-Modell, das an KI-Agenten hängt, ebenso wenig.
Für alle, die über n8n oder ähnliche Werkzeuge arbeiten, heißt das: Von dieser Preissenkung kommt über die Standardknoten nichts an. Wer sie nutzen will, muss die Schnittstelle selbst ansprechen und den Anfragekörper von Hand bauen.
Caching läuft ohnehin nicht von allein. Es muss in der Anfrage angefordert werden. Anthropic nennt zwar eine automatische Variante, aber automatisch ist daran nur die Platzierung, nicht das Einschalten.
Wann Caching sich lohnt und wann es teurer wird
Die Schwelle ist niedriger, als man denkt. Etwas in den Cache zu legen kostet einmalig das 1,25-fache des normalen Eingabepreises. Jeder spätere Lesevorgang kostet nur noch ein Vierzigstel des normalen Eingabepreises. Damit lohnt sich der Cache schon beim zweiten Aufruf. Die Stundenvariante kostet beim Hinterlegen das Doppelte und lohnt sich ab dem dritten.
Teurer wird es in zwei Fällen. Wird etwas hinterlegt und nie wieder gelesen, zahlt man 25 Prozent Aufschlag, bei der Stundenvariante das Doppelte.
Der zweite Fall ist tückischer, und Anthropic beschreibt ihn selbst als häufigen Fehler. Abgelegt wird nie ein einzelnes Textstück, sondern immer der Anfang der Anfrage bis zu einer selbst gesetzten Marke. Alles vor dieser Marke muss beim nächsten Aufruf zeichengenau identisch sein, sonst gibt es keinen Treffer.
Setzt man die Marke hinter den wechselnden Inhalt, entsteht bei jedem Aufruf ein neuer Eintrag und nie ein Treffer. Ein Zeitstempel im Prompt reicht dafür schon. Man zahlt dauerhaft den Aufschlag fürs Hinterlegen und bekommt nie die Ersparnis. Die Marke gehört deshalb ans Ende des Teils, der gleich bleibt.
Die Ersparnis, die 25 Mal größer ist
Beim Lesen der Modelldokumentation bin ich über zwei Sätze gestolpert, die mehr wert sind als die ganze Cache-Diskussion.
Der erste steht gleich im ersten Absatz: Für die meisten Aufgaben empfiehlt Anthropic, bei Opus 5 zu bleiben. Fable 5.1 ist für anspruchsvolles Nachdenken und lange agentische Arbeit gedacht. Opus 5 kostet die Hälfte, nämlich 5 Dollar Eingabe und 25 Dollar Ausgabe.
Der zweite steht unter Preise. Bei der Stapelverarbeitung, auch Batch-Verarbeitung genannt, schickt man seine Anfragen gesammelt weg. Die Antworten kommen dann innerhalb eines Tages statt sofort. Dafür kostet die Eingabe 5 statt 10 Dollar und die Ausgabe 25 statt 50. Minus 50 Prozent auf die gesamte Rechnung, nicht auf einen Teilposten.
Die Bedingung ist, dass man auf das Ergebnis warten kann. Bei meinem Themenscanner ist das kein Problem. Er läuft morgens, ich schaue mittags in die Karten. Auf meinen Lauf gerechnet: 1,90 Dollar statt 3,81. Das sind 1,91 Dollar Ersparnis, gegenüber 7 Cent aus der Cache-Senkung. Also 25 Mal mehr.
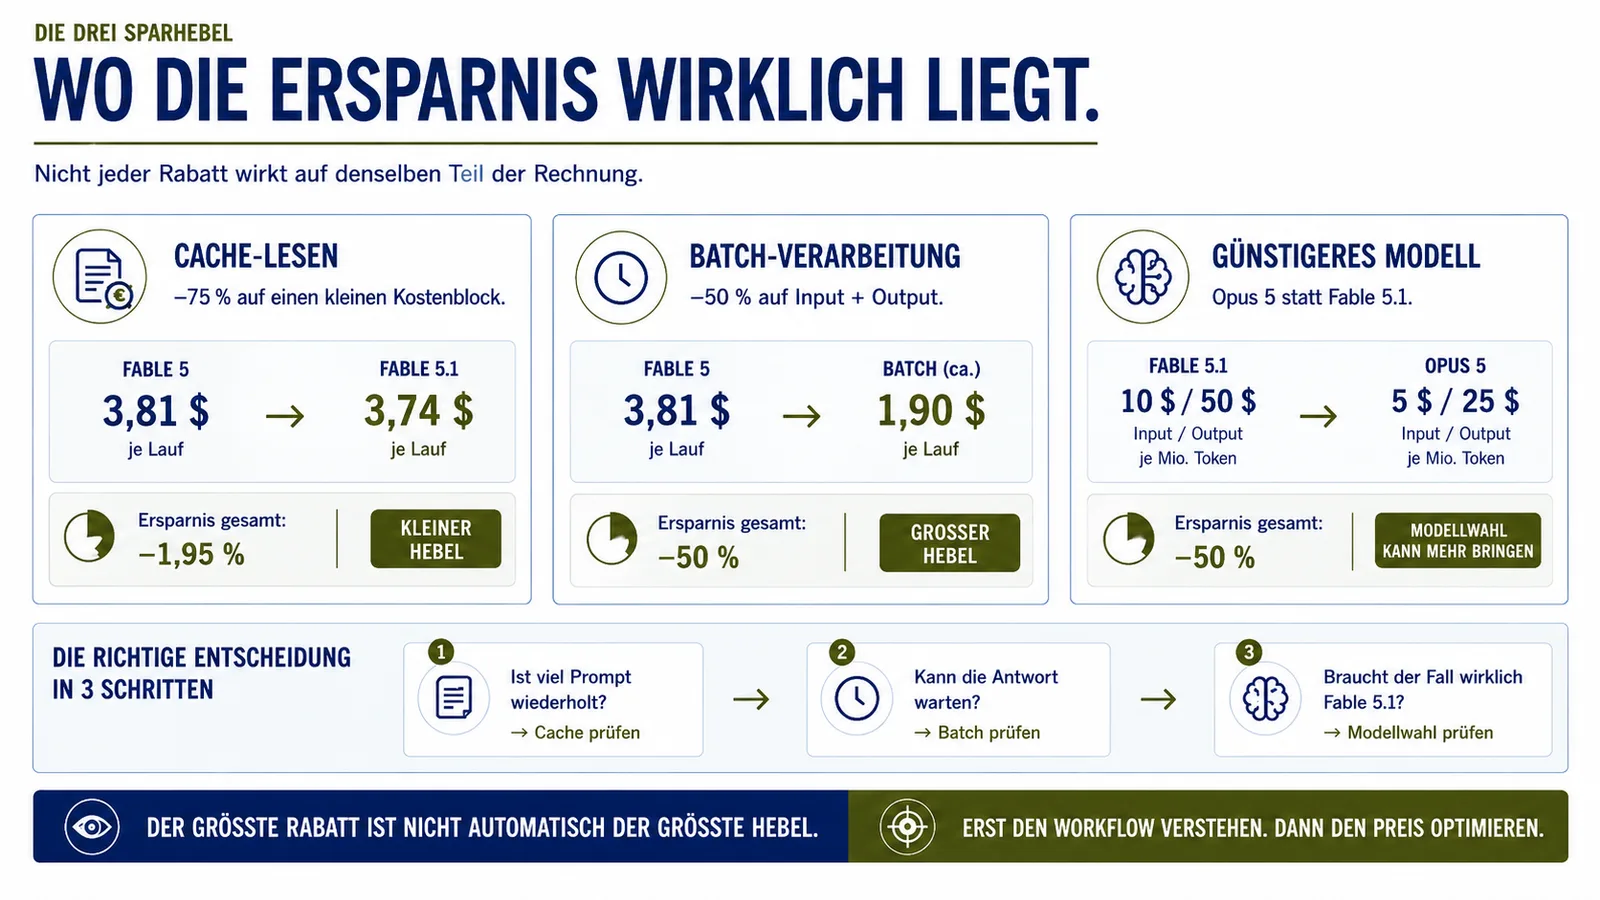
Die Meldung der Woche war die Preissenkung. Der Hebel lag in derselben Preistabelle, zwei Zeilen tiefer.
Was sonst neu ist und Agenten betrifft
Zwei Änderungen in der Modelldokumentation sind wichtiger als die Preisdiskussion, wenn du Agenten betreibst.
Erzwungene Werkzeugaufrufe funktionieren nicht mehr. Gemeint ist die Einstellung, mit der man dem Modell vorschreibt, auf jeden Fall ein bestimmtes Werkzeug zu benutzen, etwa eine Websuche. Wer das bisher gesetzt hat, bekommt jetzt einen Fehler zurück. Erlaubt ist nur noch, dass das Modell selbst entscheidet, oder gar keine Werkzeuge. Das ist ein Bruch, der bestehende Abläufe stoppt.
Dazu verteilt Fable 5.1 parallele Werkzeugaufrufe unregelmäßiger als der Vorgänger. Anthropic schreibt selbst, dass daraus mehr Durchläufe, mehr Token und mehr Wartezeit entstehen können. Ein günstigerer Lesepreis nützt wenig, wenn dafür die Zahl der Aufrufe steigt.
Was ich in Projekten ändere
Ich habe aufgehört, auf Preismeldungen zu reagieren, und stattdessen nachgesehen, woraus meine Rechnung besteht. Bei diesem Workflow sind es 48 Prozent Artikeltexte und 50 Prozent Ausgabe. Wer dort sparen will, braucht keinen Cache.
Konkret prüfe ich jetzt zwei Dinge, bevor ich an einem Modell drehe. Erstens, ob der Ablauf überhaupt auf eine sofortige Antwort angewiesen ist. Wenn nicht, ist Stapelverarbeitung die halbe Rechnung. Zweitens, ob das teurere Modell wirklich nötig ist. Anthropic selbst schickt einen für die meisten Fälle zurück zu Opus 5.
Dazu protokollieren wir jetzt pro Aufruf, wie viele Token geschrieben, gelesen und frisch verarbeitet wurden. Die Schnittstelle liefert diese drei Werte mit jeder Antwort. Erst damit sieht man, ob Caching greift, statt es zu vermuten.
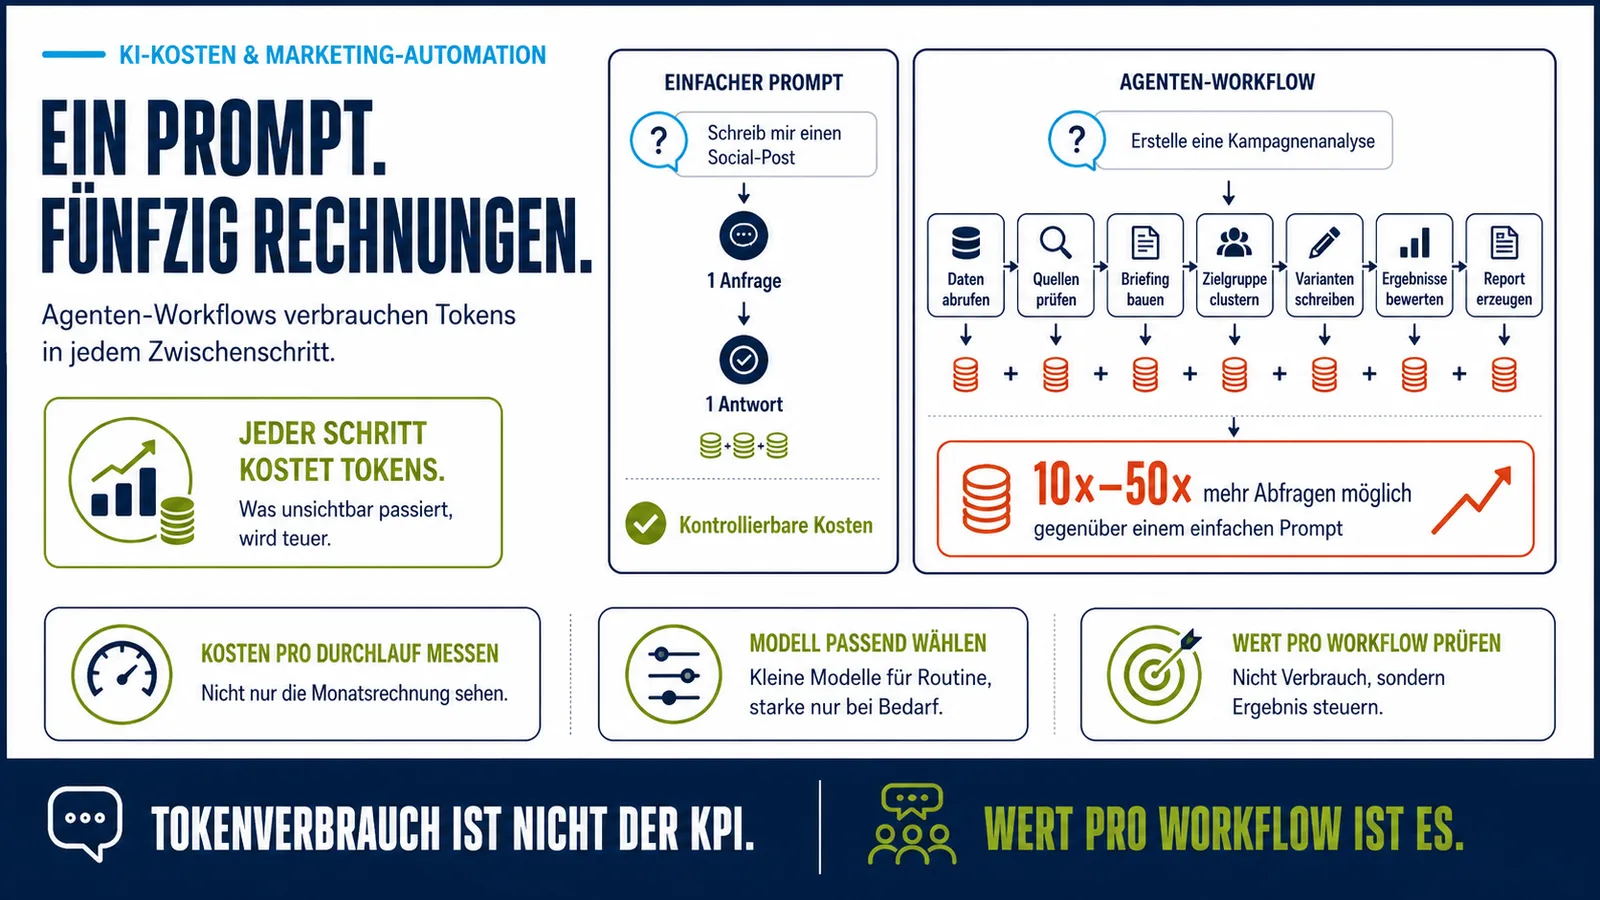
Es ist derselbe Punkt wie bei den Kosten in Agenten-Workflows. Ohne Sicht auf die Aufschlüsselung diskutiert man über Preislisten statt über die eigene Rechnung.
Womit ich diese Woche anfangen würde
Nimm deinen teuersten Ablauf und teile die Rechnung in drei Teile: wiederholter Prompt, neuer Input, Ausgabe. Diese Aufteilung sagt dir in fünf Minuten, ob eine Preissenkung beim Cache dich überhaupt betrifft.
Dann stell die Frage, die mehr bringt: Braucht dieser Ablauf die Antwort sofort? Wenn nicht, halbiert Stapelverarbeitung die Rechnung. Das gilt seit Langem und hat mit dem neuen Modell nichts zu tun.
Wenn du erzwungene Werkzeugaufrufe nutzt, teste vor einem Wechsel auf Fable 5.1. Die liefern jetzt einen Fehler zurück. Er kommt sofort, aber nur, wenn jemand hinschaut.