Geteiltes Gedächtnis: Warum der zweite Agent bei null anfängt
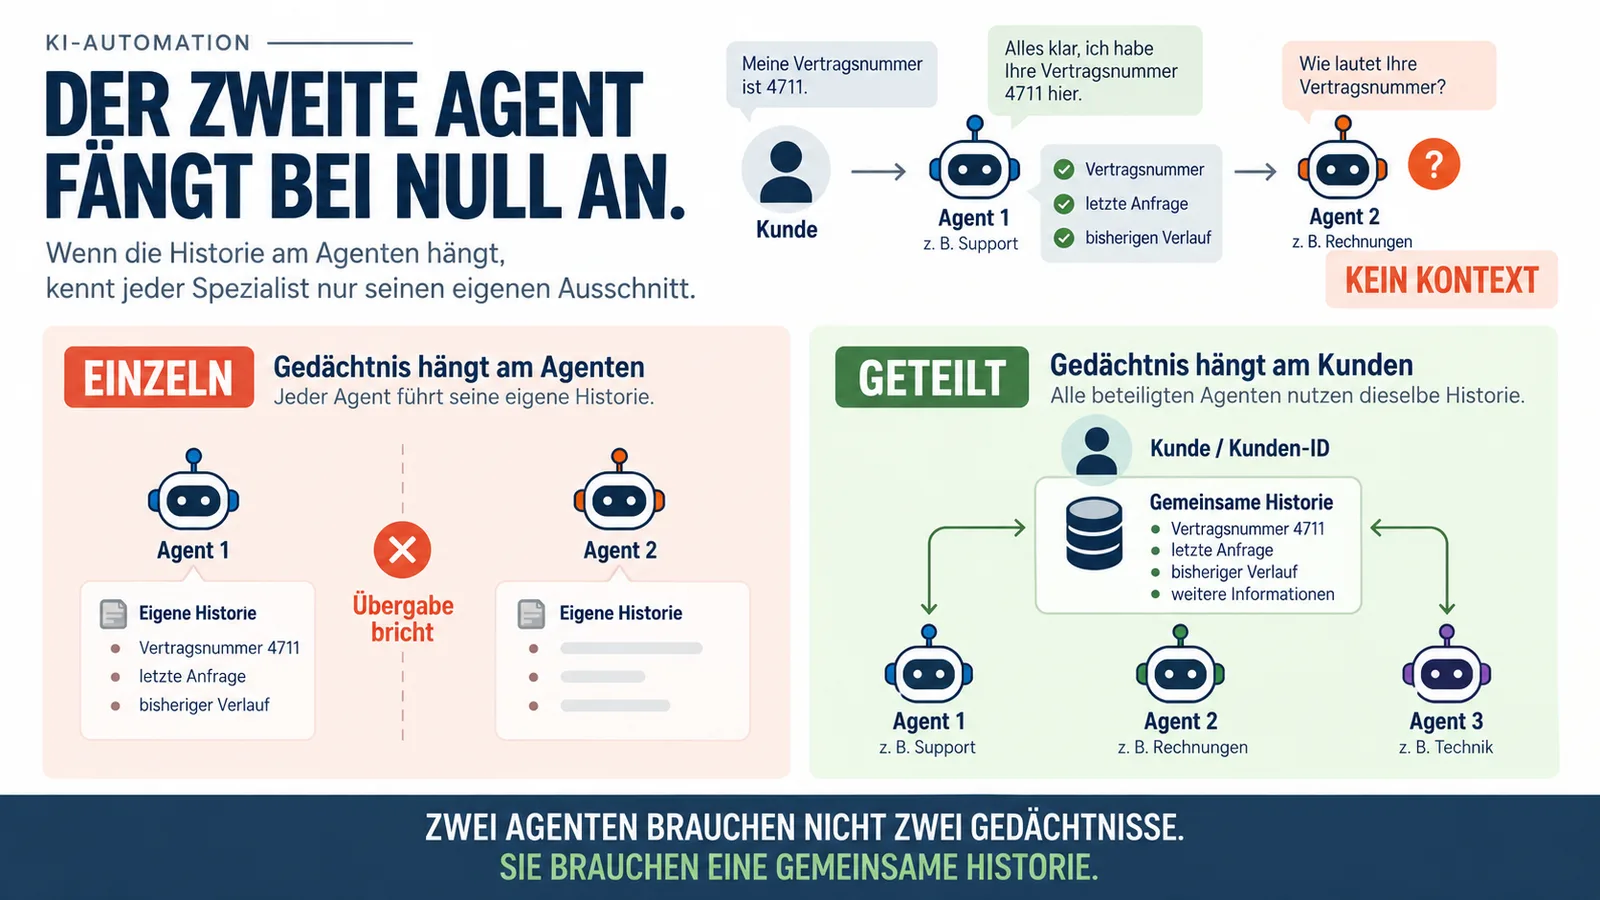
In einem Kundenprojekt hing die Gesprächshistorie am Chatbot-Werkzeug. Als ein zweiter Agent für Rechnungsfragen dazukam, war sie für ihn unsichtbar. Der Kunde nannte seine Vertragsnummer zum dritten Mal. Was danach umgebaut werden musste, hat länger gedauert als der Bau des zweiten Agenten.
Warum der zweite Agent bei null anfängt
Für den Anrufer ist das ein Gespräch mit einem Unternehmen. Im Ablauf sind es zwei Agenten, und der zweite startet ohne Vorwissen.
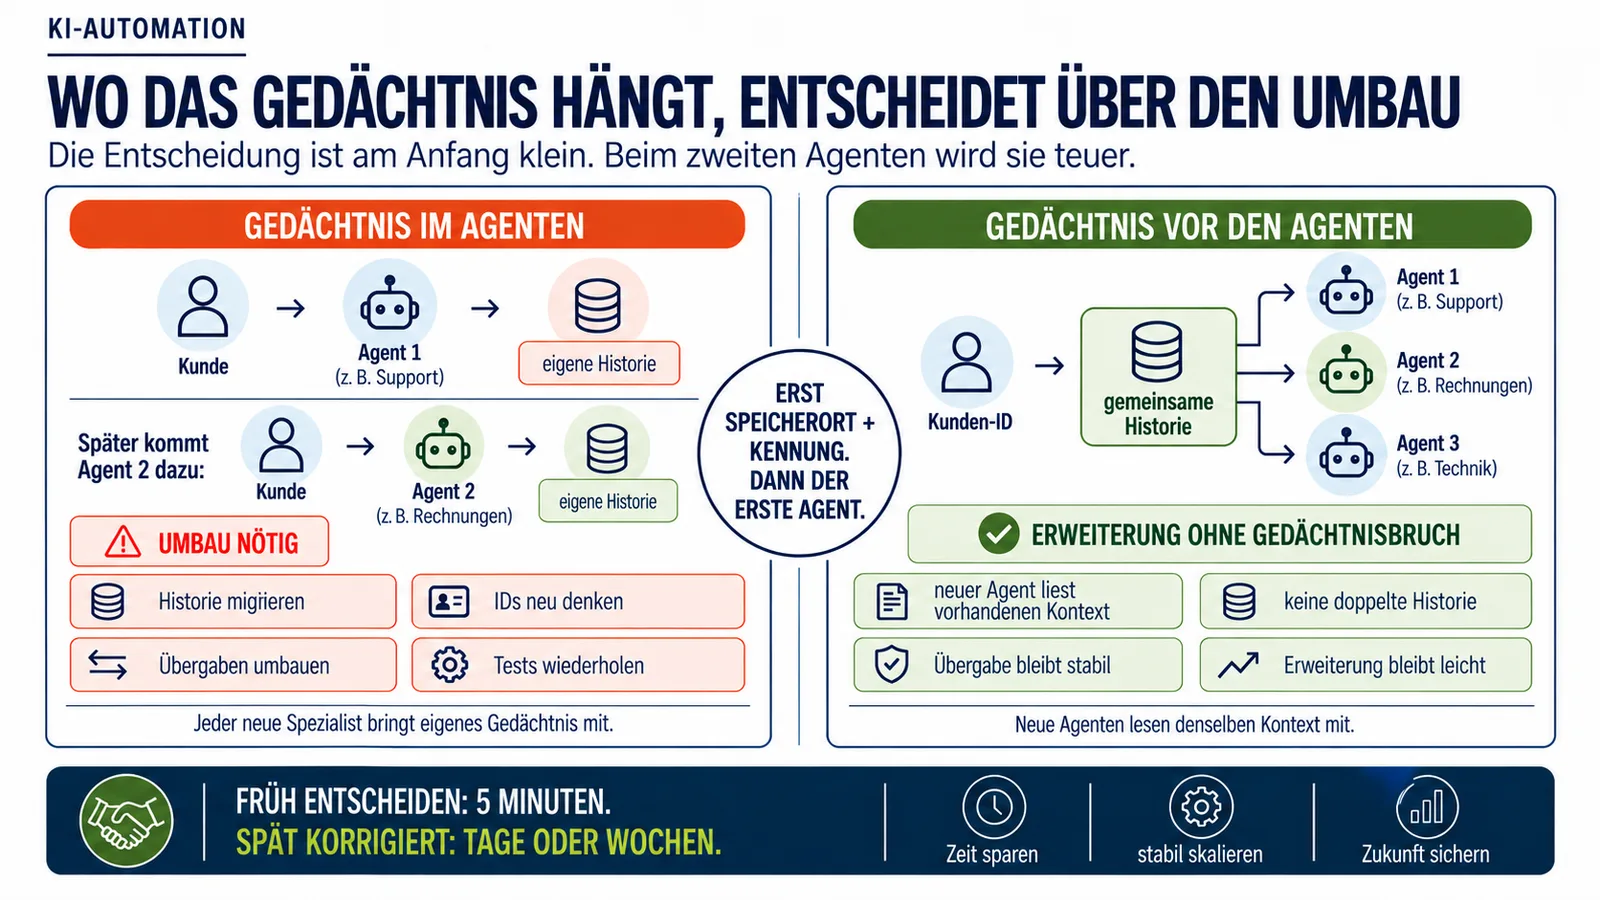
Der Grund steckt im Aufbau. Das Gedächtnis hängt am Agenten, nicht am Kunden. Jeder Agent führt seine eigene Historie, und wer später dazukommt, sieht die der anderen nicht.
Zwei Auswege sind üblich, beide haben einen Preis. Du reichst das vollständige Gesprächsprotokoll an jeden Spezialisten weiter. Das trägt, bis das Gespräch länger wird als das, was das Modell auf einmal lesen kann. Die Alternative ist eine eigene Datenbank für die Historie. Dann betreibst du ab sofort eine Datenbank mit, samt Pflege und Kosten.
Die Frage gehört vor den ersten Agenten
Wem gehört die Gesprächshistorie? Dem Agenten, dem Werkzeug oder dem Kunden?
Solange nur ein Agent läuft, ist die Antwort egal. Sie wird in dem Moment teuer, in dem der zweite dazukommt, und das ist selten der geplante Moment. In meinem Fall war der Umbau aufwendiger als alles, was danach kam.
Deshalb kläre ich das inzwischen vor dem ersten Knoten. Die Kennung, unter der die Historie gespeichert wird, muss den Kunden bezeichnen und nicht den Agenten. Das ist eine Entscheidung von fünf Minuten, wenn man sie früh trifft.
Wie AWS das gelöst hat
Amazon Bedrock AgentCore hängt die Historie an eine Kennung für den Kunden statt an den einzelnen Agenten. Vergibst du diese Kennung, lesen und schreiben alle beteiligten Agenten dieselbe Historie, und sie überlebt den einzelnen Durchlauf.
Beschrieben hat das Sundar Raghavan von AWS im n8n-Blog. Der Beitrag kommt vom Anbieter selbst, die Zahlen darin habe ich deshalb gegengeprüft.
Ein zweiter Punkt daraus ist praktisch. Die Angaben zu Modell, Werkzeugen und Anweisungen reisen bei jedem Aufruf mit. Eine einzige Ressource bedient damit alle vier Rollen im Beispiel, statt vier Agenten einzeln zu betreiben. Der n8n-Knoten dafür ist ein verifizierter Community-Node, im Beispiel liegen zehn Knoten und zwei Zugänge auf der Fläche.
Das ist eine Lösung von vielen. Wer bereits eine Datenbank betreibt, löst dasselbe damit. Interessant ist die Bauform, nicht der Anbieter.
Was es kostet
Das Gerüst selbst ist kostenlos, bezahlt wird die Nutzung. AWS rechnet drei Posten ab: 0,25 Dollar je 1.000 neue Gesprächsereignisse, 0,75 Dollar je 1.000 dauerhaft gespeicherte Einträge im Monat und 0,50 Dollar je 1.000 Abrufe. Die Preisübersicht führt die Varianten auf.
Für einen Support-Kanal mit ein paar hundert Gesprächen im Monat bewegt sich das im einstelligen Bereich. Der Posten, der wächst, sind die Abrufe, denn jeder Agent liest bei jeder Übergabe.
Der Teil, der in keinem Produktblatt steht
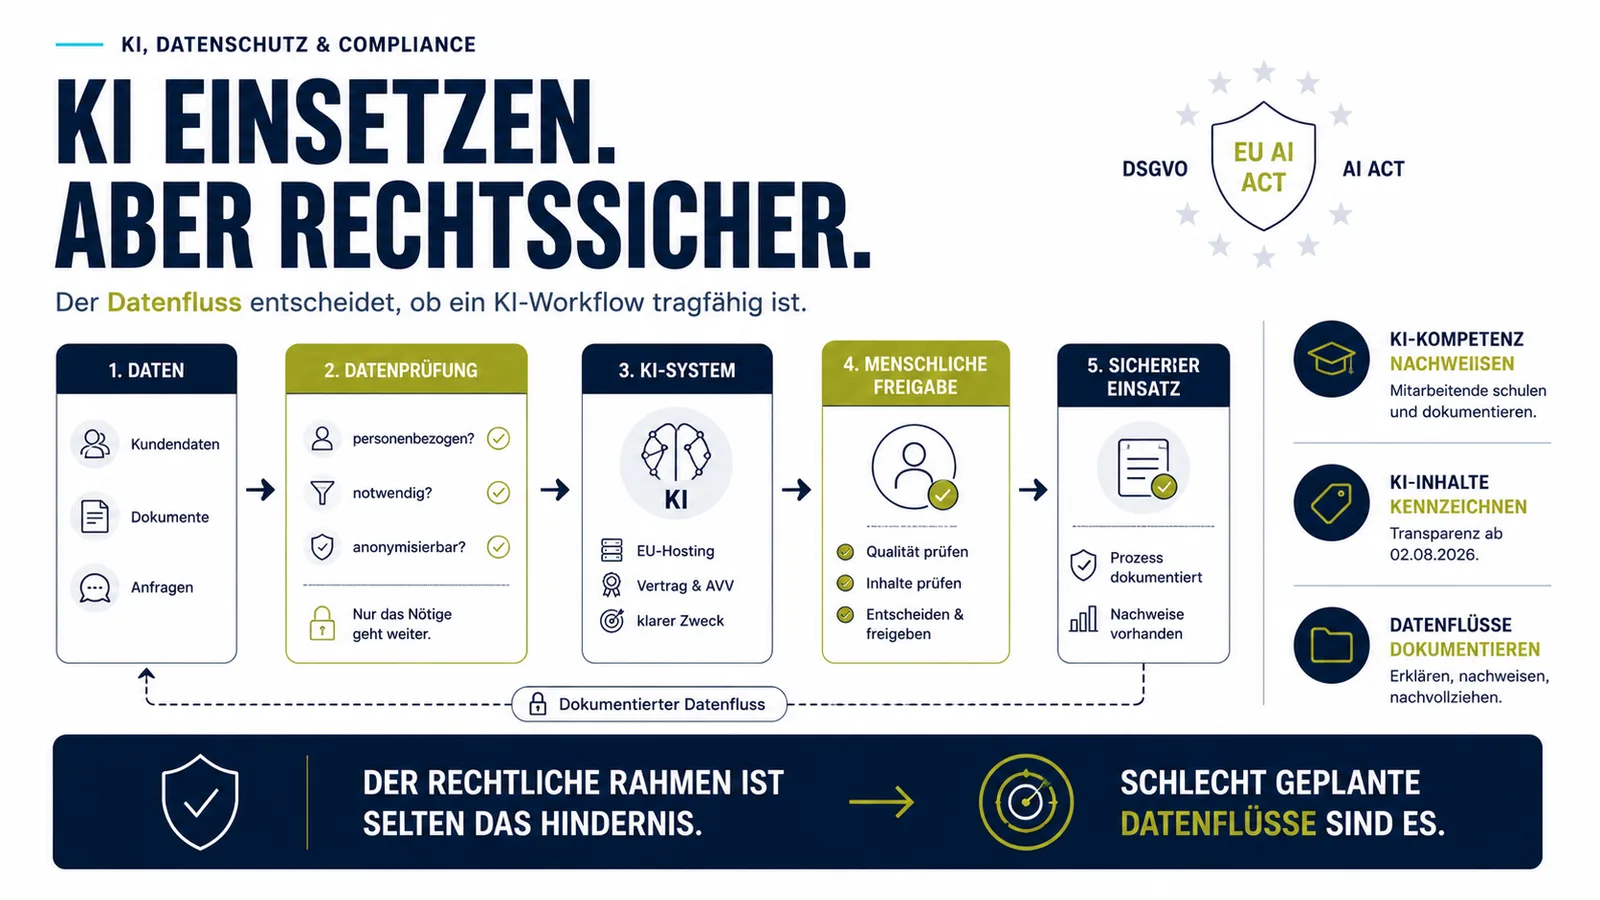
Ein kundenbezogenes Gedächtnis speichert personenbezogene Daten über den einzelnen Lauf hinaus. Damit wird aus einer technischen Entscheidung eine rechtliche.
Zu klären ist dreierlei, bevor das erste echte Gespräch darüber läuft: in welcher Region die Daten liegen, wann sie gelöscht werden und ob ein Vertrag zur Auftragsverarbeitung vorliegt. Das gilt für jede Lösung, auch für die eigene Datenbank im eigenen Keller.
Die Löschfrist ist der Punkt, der am häufigsten fehlt. Ein Gedächtnis, das den einzelnen Lauf überlebt, überlebt ohne Regel auch das Kundenverhältnis. Was dabei sonst zu beachten ist, habe ich unter DSGVO-konformer KI zusammengeschrieben.
Was ich in Projekten ändere
Ich baue das Gedächtnis inzwischen vor die Agenten statt in sie hinein. Erst steht fest, wo die Historie liegt und unter welcher Kennung. Danach kommt der erste Agent.
Das klingt nach einer Kleinigkeit und ist der Unterschied zwischen einer Erweiterung von einem Tag und einer von zwei Wochen. Wer die Historie besitzt, entscheidet über die Kosten jeder späteren Erweiterung.
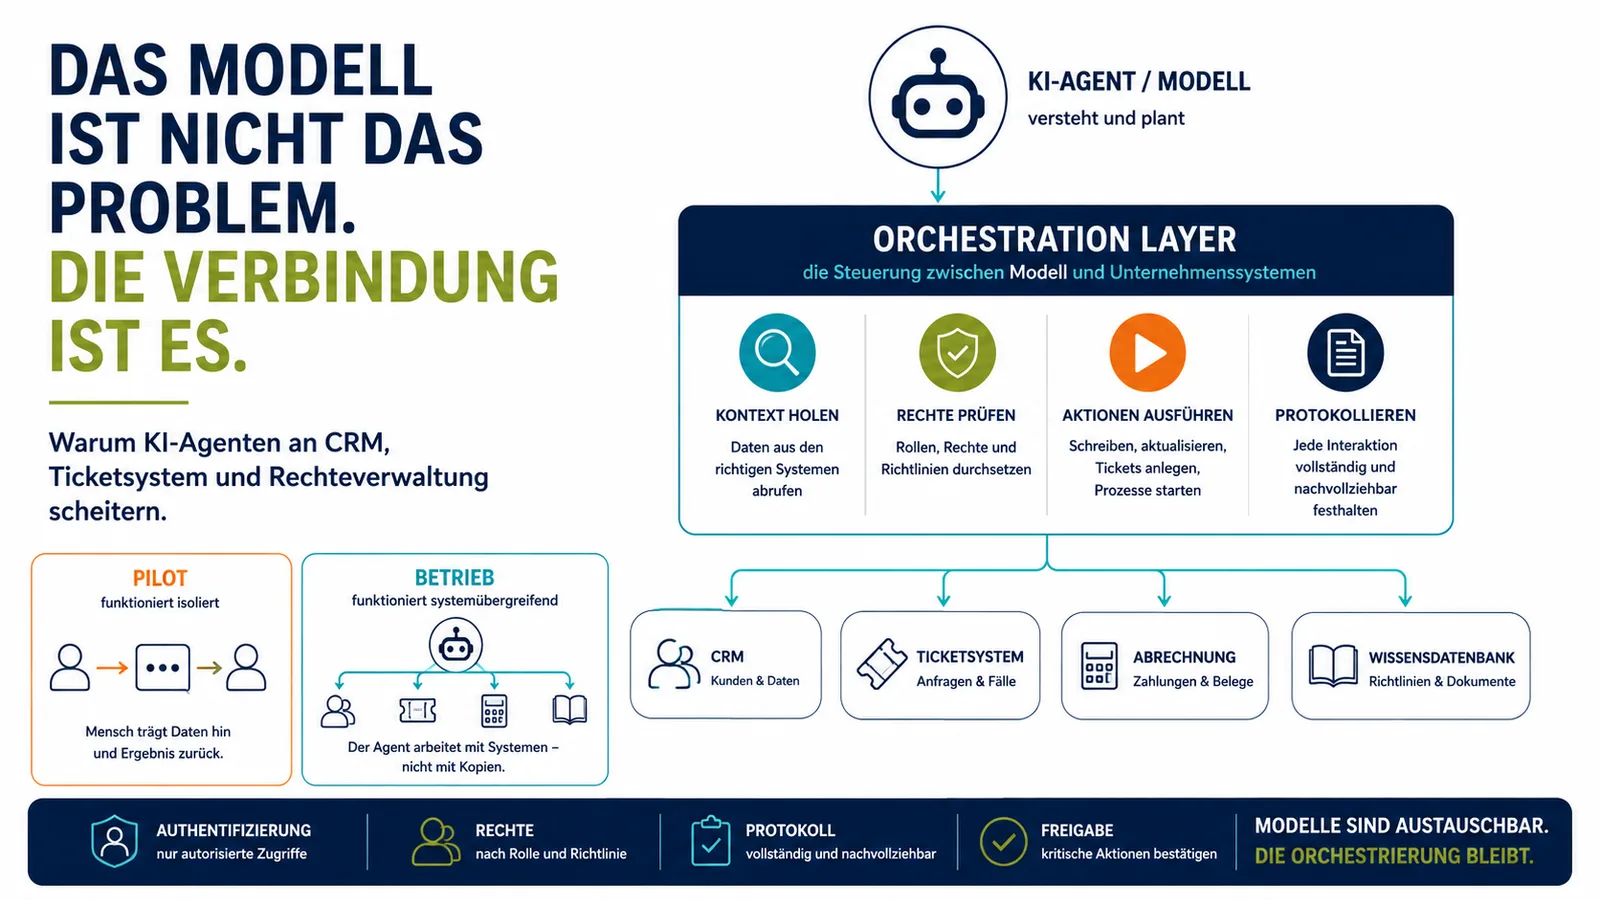
Dazu protokolliere ich bei jeder Übergabe mit, welcher Agent welche Historie gesehen hat. Ohne das merkst du einen Gedächtnisbruch erst, wenn ein Kunde sich beschwert. Wie ich Agenten sonst aufeinander abstimme, steht im Orchestration Layer.
Womit ich anfangen würde
Schick zwei Fragen desselben Kunden nacheinander durch dein bestehendes Setup. Die zweite muss sich auf die Antwort der ersten beziehen und von einem anderen Agenten beantwortet werden.
Fragt dieser Agent nach, hast du deinen Gedächtnisbruch gefunden und weißt, welche Kennung fehlt. Der Test dauert zehn Minuten und sagt dir mehr als jeder Werkzeugvergleich.
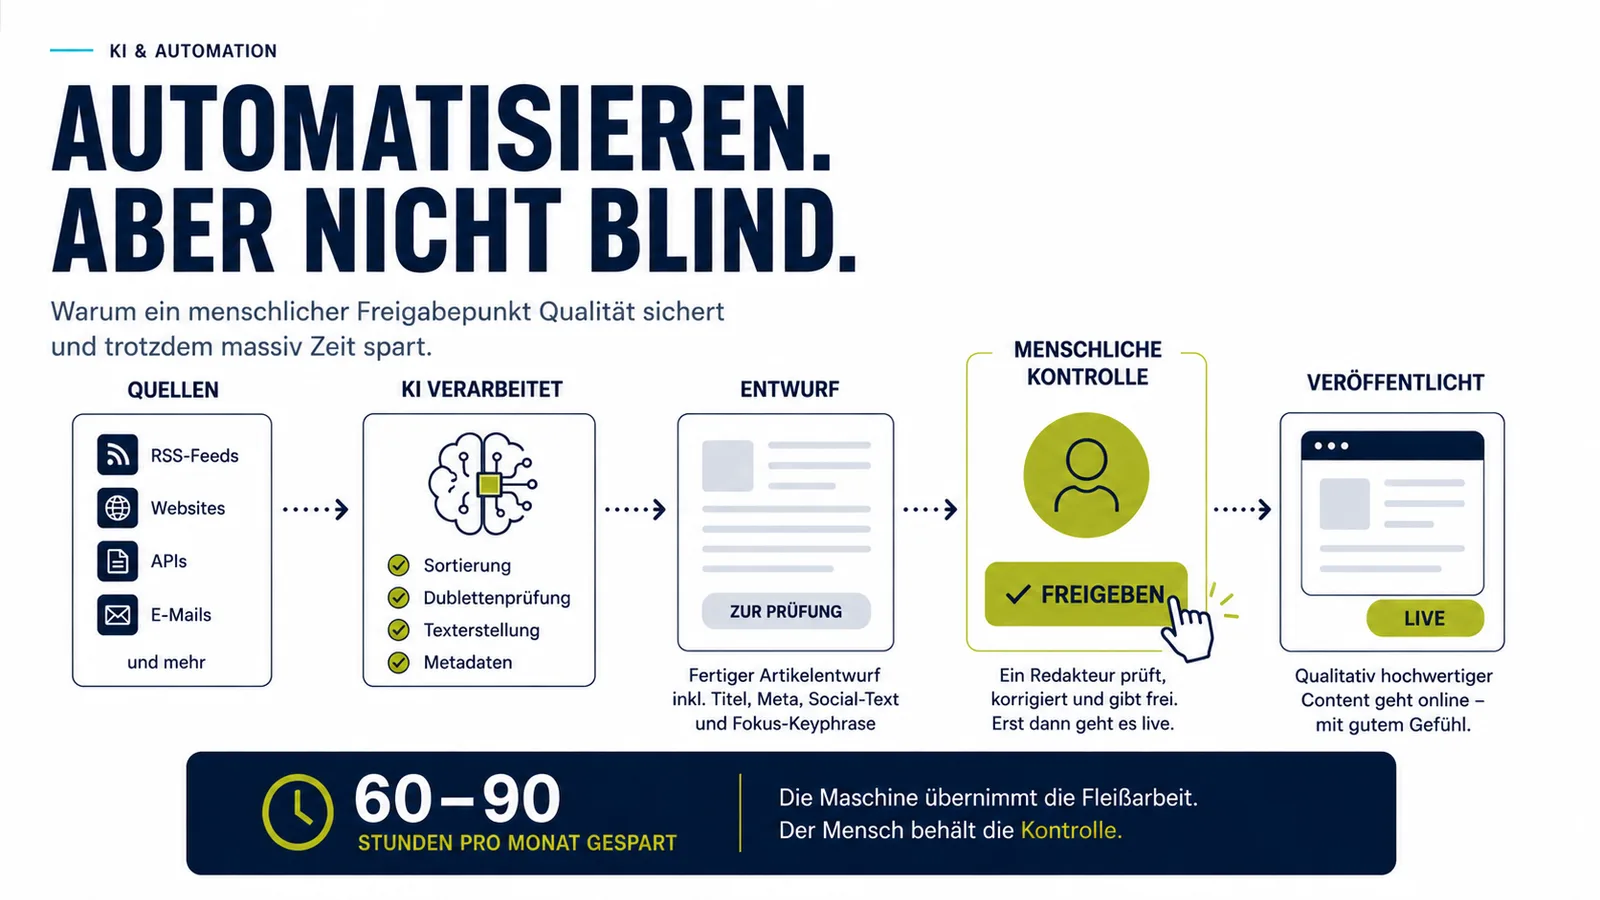
Wenn dabei herauskommt, dass du überhaupt erst einen zweiten Agenten brauchst: Prüf vorher, ob ein einzelner mit mehr Werkzeugen reicht. Zwei Agenten sind zwei Gedächtnisse und zwei Fehlerquellen. Die Leitplanken dazu stehen unter KI-Automation mit Kontrolle.